자동화 후기

  • AI 블로그 자동화, 경쟁 글 분석 기능 테스트 7개 통과시켰다

    AI 블로그 자동화, 경쟁 글 분석 기능 테스트 7개 통과시켰다

    AI 블로그 자동화 파이프라인을 돌리면서도, 정작 경쟁 글 구조는 한 번도 체계적으로 분석한 적이 없었다. 글을 잘 쓰는 것과 검색에 상위 노출되는 것은 다른 문제다.

    그 사실을 알면서도 나는 꽤 오랫동안 내 경험만 믿고 글 구조를 짰다. 경쟁자가 뭘 쓰는지는 봤지만, 그들이 어떤 흐름으로 소제목을 배치하는지는 한 번도 체계적으로 분석하지 않았다.

    AI 블로그 자동화에 왜 남의 글 구조를 참고해야 할까 (그 글들이 상위 노출된 이유)

    상위 노출된 글은 우연히 거기 있지 않다. 검색 알고리즘(검색 시스템이 글의 품질을 평가하는 방식)이 그 글을 좋다고 판단했거나, 독자들이 오래 머물렀거나, 두 가지가 동시에 일어난 것이다.

    내 블로그 자동화 파이프라인(pipeline, 여러 작업을 순서대로 연결한 처리 흐름)에는 outline-writer.ts라는 에이전트(agent, 특정 임무를 수행하는 AI 프로그램 단위)가 있었다.

    이 에이전트는 내가 제공한 인터뷰, 즉 실제 경험 데이터만 보고 글의 구조를 짰다. 네이버 검색 키워드는 미리 조사해서 넣었다. 여기까지는 괜찮았다.

    문제는 그다음이었다.

    같은 키워드로 구글과 네이버에 실제로 어떤 글이 뜨는지, 그 글들이 소제목을 어떤 순서로 배치하는지, 키워드를 어느 위치에 박아 넣는지 — 이걸 전혀 참고하지 않았다. 검색 의도(사용자가 검색할 때 실제로 원하는 정보)를 무시한 채 구조를 짠 셈이다.

    상위 노출 글의 구조는 그 자체가 데이터다. 베끼자는 게 아니다. 어떤 흐름이 먹히는지 확인하자는 것이다.

    경쟁 글 분석 에이전트를 따로 만든 이유 (구조만, 문장은 절대 아니)

    가장 먼저 정해야 할 선이 있었다. 구조를 참고하는 것과 문장을 베끼는 것은 완전히 다르다. 저작권 문제를 떠나서, 남의 문장을 그대로 가져오면 내 글이 될 수 없다.

    AI 블로그 자동화를 에이전트 하나가 다 떠맡게 하고 싶지 않았다. 그래서 새 에이전트를 따로 만들었다. agents/competitor-analyzer.ts다.

    이 에이전트가 하는 일은 하나다.

    경쟁 글에서 제목, 소제목(H2) 흐름, 키워드 배치 위치만 뽑아내는 것. 본문 문장은 가져오지 않는다. 이 제약을 코드 레벨이 아니라 프롬프트(AI에게 주는 지시문) 레벨에서 명확하게 걸었다.

    왜 outline-writer에 기능을 얹지 않고 에이전트를 새로 만들었을까. 역할이 다르기 때문이다.

    분석과 집필은 분리해야 나중에 고치기 쉽다. 하나의 에이전트가 두 가지 일을 동시에 하면, 문제가 생겼을 때 어디서 틀렸는지 찾기 어려워진다.

    web_search 도구로 상위 글 2~3개를 찾아 JSON으로 뽑기

    구현은 AI 블로그 자동화 파이프라인에서 이 부분이 핵심이다. 앤트로픽 SDK(소프트웨어 개발 키트, AI 기능을 코드에서 쓸 수 있게 해주는 도구 묶음)의 web_search 서버 도구를 사용했다.

    주제와 관련된 구글 상위 글 2~3개를 찾고, 거기서 구조 정보만 JSON(JavaScript Object Notation, 데이터를 구조화해서 저장하는 텍스트 형식)으로 추출하는 방식이다.

    모델(AI 엔진)은 claude-haiku-4-5를 썼다. outline-writer와 같은 모델이다. 여기서 한 가지 막히는 부분이 있었다.

    web_search 도구에는 두 가지 변형이 있는데, 동적 필터링(검색 조건을 더 세밀하게 조절하는 기능)을 지원하는 최신 버전인 web_search_20260209는 claude-haiku-4-5에서 쓸 수 없었다.

    기본형인 web_search_20250305만 지원됐다. 중간에 알게 돼서 맞췄다.

    pause_turn 처리와 결과물

    또 하나 신경 써야 했던 부분이 있다. 검색 도중 stop_reason(AI가 응답을 멈춘 이유)이 pause_turn으로 끊기는 경우가 생겼다.

    AI가 검색 결과를 받아오는 도중에 중간에 멈추는 현상이다. 이 경우를 처리하기 위해 최대 3번까지 재시도하는 루프를 넣었다.

    AI 블로그 자동화 파이프라인이 실제로 쓰는 데이터는 이거다. 각 경쟁 글마다 제목, H2 소제목 목록, 키워드가 등장하는 위치를 JSON 형태로 정리한 구조 데이터다. 문장은 없다. 뼈대만 있다.

    아래는 테스트가 전부 통과한 시점의 캡처다.
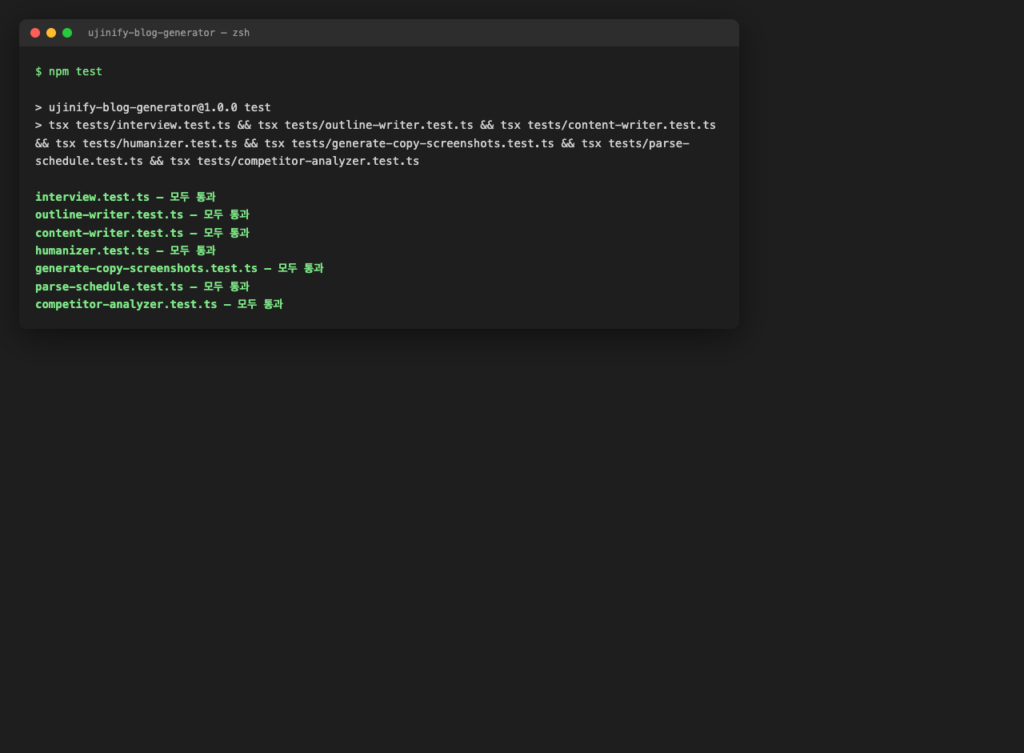
    AI 블로그 자동화 경쟁 글 분석 에이전트 테스트 7개 통과 터미널 캡처

    7개 테스트 파일이 모두 초록불이다. competitor-analyzer.test.ts가 새로 추가된 파일이다.

    outline-writer에 분석 결과를 선택적으로 연결하는 방법

    AI 블로그 자동화 파이프라인에서 분석과 집필을 분리한 이유가 여기서 드러난다.

    competitor-analyzer.ts가 뽑아낸 JSON 결과를 outline-writer.ts에 그냥 던져주면 안 된다. 선택적으로 연결해야 한다.

    outline-writer.ts는 이 분석 결과를 선택적 인자로 받는다.

    분석 결과가 있으면 프롬프트 안에 포함되고, 없으면 기존 방식대로 동작한다. 여기서 프롬프트 문구가 중요하다. 단순히 데이터를 붙여 넣는 게 아니라, 이런 문구를 명시한다.

    참고용 , 절대 베끼지 말고 어떤 흐름이 먹히는지만 참고

    이 한 줄이 없으면 AI는 경쟁 글의 소제목을 그대로 가져올 수 있다. 지시를 명확하게 줘야 한다.

    파이프라인 전체 흐름에서 이 단계의 위치는 이렇다. 인터뷰 데이터를 로드하고 나서, outline을 생성하기 전에 경쟁 글 분석 단계를 끼워 넣었다.

    generate.ts가 이 순서를 관리한다. 순서가 바뀌면 의미가 없다. 분석 결과가 outline보다 먼저 나와야 참고가 된다.

    인스타 숏폼에서 배운 ‘훅’과 ‘피크엔드’ 원칙을 프롬프트에 녹이기

    같은 날 인스타 릴스 영상을 하나 봤다.

    릴스 기획을 AI한테 시키는 방법을 설명하는 영상이었다. 숏폼 영상 기획 공식 세 가지를 소개했다. 도입 3초 훅, 결말 피크엔드 법칙, 중간 반전.

    릴스에서 본 걸 그대로 믿지 않고 AI 블로그 자동화 작업에 가져오기 전에 직접 검증해보는 건 이전에도 한 적이 있다.

    이 중 두 가지는 텍스트 블로그에도 쓸 수 있었다. 나머지 하나는 못 썼다.

    화면 방향 전환이나 다음 영상으로 유도하는 클리프행어는 영상 전용 요소다. 텍스트에 옮기는 건 억지다. 그래서 뺐다.

    가져온 두 가지는 이것이다.

    • 인지 부조화 훅 , 도입부에서 서로 어울리지 않는 개념을 나란히 붙이거나, 독자가 예상하지 못한 사실을 먼저 던져서 궁금증을 만든다. 읽고 싶게 만드는 첫 문장이다.
    • 피크엔드 법칙 , 결론을 흐지부지 요약하지 않는다. 글에서 가장 중요한 성과나 숫자를 마지막에 다시 한번 짚으며 끝낸다. 사람은 절정과 마지막 순간을 가장 선명하게 기억한다.

    프롬프트에 실제로 반영한 곳

    이 두 원칙을 프롬프트 문구로 만들어서 두 군데에 넣었다.

    outline-writer.ts에는 제목 작성 지침과 마지막 소제목 지침에 반영했다. content-writer.ts에는 첫 문단 작성 지침과 결론 지침에 반영했다.

    아래는 outline-writer.ts와 content-writer.ts 프롬프트에 지침이 추가된 코드 캡처다.
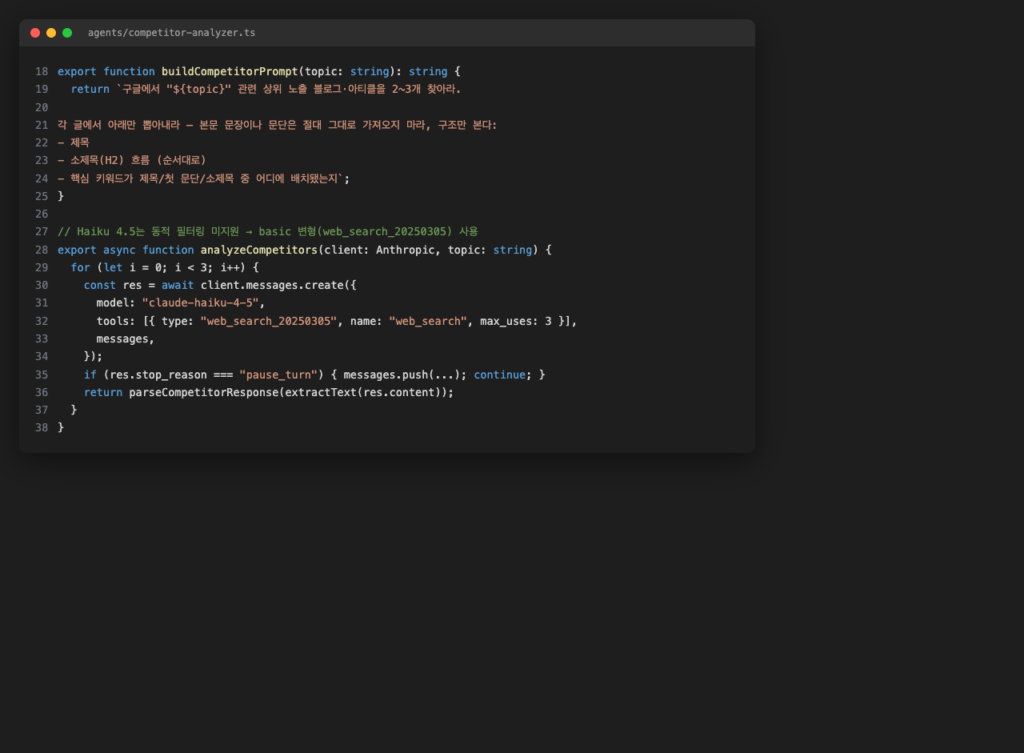
    AI 블로그 자동화 competitor-analyzer.ts 코드 ,  web_search 도구와 pause_turn 재시도 루프

    텍스트로 적혀 있는 지침이지만, AI가 이 문구를 받으면 실제로 첫 문단과 결론을 다르게 쓴다.

    5가지 테스트 케이스로 검증하고, 실전 테스트는 아직 남았다

    AI 블로그 자동화 기능 하나를 추가했다고 테스트를 건너뛸 수는 없다. 코드를 짜고 나서 바로 테스트를 작성했다. competitor-analyzer.test.ts다. 확인한 케이스는 다섯 가지다.

    • 프롬프트 안에 주제와 ‘그대로 가져오지 말라’는 제약 문구가 실제로 들어가는지
    • 정상적인 JSON 응답이 제대로 파싱되는지
    • posts 필드(데이터 항목)가 없을 때 빈 배열로 폴백되는지
    • 검색 결과가 아예 없을 때도 posts: []로 정상 처리되는지
    • 응답 앞뒤에 “검색해보겠습니다” 같은 설명 텍스트가 붙어도 JSON만 정확히 추출되는지

    테스트는 통과했지만, 실전은 아직

    npm test를 실행했다. 기존 6개 테스트 파일에 새 파일이 더해져 총 7개 파일이 전부 통과했다.

    솔직하게 적어야 하는 부분이 있다. 코드와 테스트는 끝났다.

    하지만 실제로 npm run generate를 돌려서 경쟁 글 분석 결과가 실전 outline에 얼마나 잘 반영되는지는 아직 확인하지 않았다. 실행 결과를 본 적이 없다. 이 부분은 모른다.

    테스트 통과와 실전 동작은 다르다. 이건 늘 그렇다. 코드가 맞아도 AI의 실제 출력이 기대와 다를 수 있다. 그걸 확인하는 것이 다음 단계다.

    이번 작업에서 실제로 이뤄진 것은 이것이다.

    경쟁 글 구조를 자동으로 분석하는 에이전트 1개 추가, 테스트 케이스 5개 작성, 총 7개 테스트 파일 전부 통과. 코드와 테스트는 여기까지 증명했다.

    그런데 outline-writer가 이 분석 결과를 실제 글쓰기에 얼마나 반영할지는 아직 모른다. npm run generate를 처음 돌렸을 때, 결과물이 기대와 같을까 다를까.
  • 블로그 키워드 리서치를 뒤늦게 적용한 5개 글, 실제 수정 사례

    블로그 키워드 리서치를 뒤늦게 적용한 5개 글, 실제 수정 사례

    aidojin.com에 새 글을 올리기 시작하면서, 자연스럽게 이미 올라간 글들이 눈에 걸렸다. ujinify.com에는 2026년 10월 5일부터 글 쓰기 전에 네이버 검색광고 API로 키워드부터 조회하는 규칙이 있었다. aidojin.com에는 그 규칙이 없었다. 새 글부터는 블로그 키워드 리서치를 똑같이 적용하기로 했는데, 그러면 기존 5개 글은?

    무시하기가 좀 찜찜했다. 그래서 점검했다.

    이미 올린 글 5개를 확인했다

    올라간 글은 다섯 개였다. 클로드 스킬 팩트체크, OpenCut 과장분석, Claude Code 한도 절약 팁, MCP 저장소 검증, 유튜브 에이전트 스킬 사기. 이 글들은 블로그 키워드 리서치 없이 쓴 글이었다. 주제가 있으면 그냥 썼다. 검색량을 확인한 적이 없었다.

    문제는 크게 두 종류였다.

    • 검색량이 있는 키워드가 있는데 제목이나 본문에 빠져 있는 경우
    • 아예 검색량 자체가 없는 니치 주제인 경우

    두 번째는 사실 문제가 아니다. 처음부터 검색 유입을 기대할 수 없는 주제였을 뿐이다. 진짜 문제는 첫 번째, 검색량이 있는데 놓친 경우다. 그게 아까웠다.

    네이버 검색광고 API로 블로그 키워드 리서치를 점검하는 방법

    점검 방식은 간단했다. 각 글의 제목과 주제를 보고 후보 키워드를 3~5개씩 뽑는다. 그걸 네이버 검색광고 API의 /keywordstool 엔드포인트(API의 세부 기능 주소, 공식 문서에 전체 스펙이 있다)에 넣어서 PC와 모바일 월 검색량, 경쟁도를 조회한다.

    한 가지 주의할 점이 있다. 키워드에 띄어쓰기가 들어가면 수치가 엉뚱하게 나온다. ‘Claude Code’가 아니라 ‘Claude Code’로 붙여서 조회해야 실제 검색량이 나온다. ujinify.com에서 이미 겪어서 알고 있었다.

    결과는 이렇게 나뉘었다.

    글 판정
    클로드 스킬 팩트체크 수정 가치 명확
    OpenCut 과장분석 수정 가치 명확
    Claude Code 한도 절약 팁 소폭 개선 여지 있음
    MCP 저장소 검증 검색량 없거나 내용과 안 맞음
    유튜브 에이전트 스킬 사기 검색량 없거나 내용과 안 맞음

    검색량이 높은 키워드를 놓친 3개 글, 이렇게 고쳤다

    수정한 글은 세 개다. 하나씩 본다.

    ① 클로드 스킬 팩트체크, ‘클로드 스킬 추천’이 없었다

    이 글의 원래 제목에는 ‘클로드 스킬 추천’이라는 문구가 없었다. 팩트체크 글이니까 ‘추천’이라는 단어를 의도적으로 뺀 건 아니고, 그냥 생각을 못 했다.

    API를 돌려봤더니 ‘클로드스킬추천’의 네이버 검색량이 PC 370, 모바일 90, 합계 460이었다. 경쟁도는 중간. 이 정도면 놓치기 아깝다.

    제목을 ‘클로드 스킬 추천 3가지 팩트체크 — 인스타 릴스 vs 저자 검증 결과’로 바꿨다. 본문과 이미지 alt(이미지 대체 텍스트, 검색엔진이 이미지 내용을 파악하는 데 쓰임)에도 ‘클로드 스킬 추천’을 자연스럽게 추가했다.

    ② OpenCut 과장분석, 한글 표기가 아예 없었다

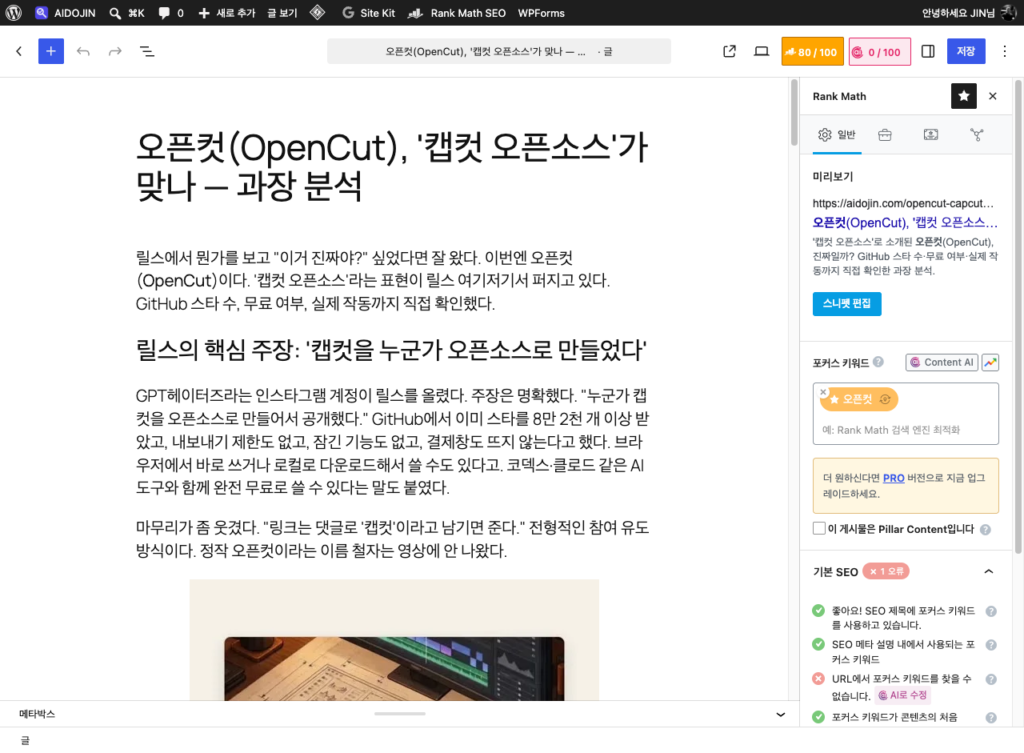
    이 글은 본문 전체에 ‘OpenCut’이라는 영문 표기만 있었다. 한글 ‘오픈컷’이 단 한 번도 나오지 않았다.

    검색량을 비교해봤다. ‘오픈컷’은 PC 100, 모바일 60, 합계 160이었다. ‘OpenCut’ 영문은 PC 40, 모바일 20, 합계 60. 한글 표기가 두 배 이상 검색된다. 당연한 결과인데, 당연한 걸 놓쳤다.

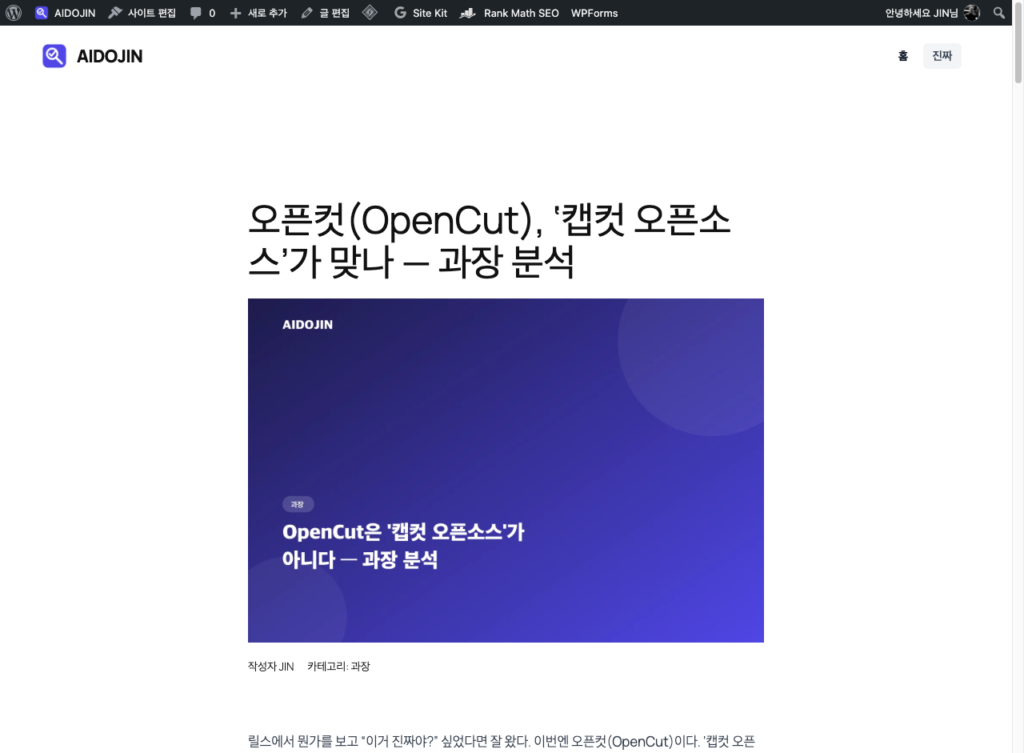
    제목에 ‘오픈컷(OpenCut)’을 병기했다. 본문에도 한글 표기를 추가했다.

    이미 올린 글 5개에 블로그 키워드 리서치를 거꾸로 적용해봤다 ,  aidojin.com 사례 스크린샷 1

    위는 수정 후 실제 라이브 페이지다. 제목이 ‘오픈컷(OpenCut), 캡컷 오픈소스가 맞나 , 과장 분석’으로 바뀌었고, 대표 이미지는 교체 전이라 아직 옛 제목이 남아 있다. upload.ts가 초기 업로드 때만 썸네일을 생성해서 그렇다. URL 슬러그는 그대로다.

    ③ Claude Code 한도 절약 팁, ‘한도’보다 ‘토큰’이 검색된다

    ‘한도’라는 단어가 제목에 있었다. 그런데 API 조회 결과 ‘클로드코드토큰’의 검색량이 PC 50, 모바일 30, 합계 80으로 경쟁도는 중간이었다. ‘한도’로는 검색되는 사람이 적었다.

    본문이 이미 캐시나 비용 얘기를 많이 다루고 있어서 ‘토큰’이라는 키워드와 내용도 맞았다. 제목의 ‘한도’를 ‘토큰’으로 바꿨다.

    이건 좀 웃겼다. 슬러그(slug, URL 주소에 들어가는 글 이름 부분)가 애초에 ‘token-saving’이었다. 영문 URL은 이미 토큰으로 돼 있는데, 한글 제목만 ‘한도’였던 거다. 뒤늦게 맞춰준 셈이 됐다.

    URL 슬러그를 안 건드린 이유, SEO 손상 방지

    슬러그는 건드리지 않았다. 이유는 단순하다. 이미 색인(인덱싱, 검색엔진이 글을 목록에 등록하는 것)됐거나 어딘가에 공유됐을 수 있는 URL을 바꾸면 그 링크가 전부 죽는다. 키워드 하나 바꾸자고 기존 SEO(검색엔진 최적화) 자산을 날릴 이유가 없다.

    수정은 제목, 메타설명(검색결과에 뜨는 글 요약 문구), 본문 텍스트에만 했다. 워드프레스 REST API(워드프레스와 외부 프로그램이 데이터를 주고받는 통로)로 title 필드만 따로 업데이트했더니 슬러그는 자동으로 유지됐다.

    슬러그를 바꿔야 할 상황이 있다면 그건 처음부터 완전히 잘못 만든 경우뿐이다. 키워드 최적화는 그 이유가 되지 않는다.

    키워드 변경 후 랭크매스 점수가 떨어진 이유와 복구 과정

    예상 못 한 문제가 나왔다. 오픈컷 글의 랭크매스(워드프레스 SEO 플러그인) 점수가 수정 후에 오히려 떨어졌다. 70점이었던 게 66점이 됐다.

    이유는 명확하다. 포커스 키워드를 바꾸면, 기존에 그 키워드에 맞춰 세팅된 밀도·링크 체크가 전부 새 키워드 기준으로 재계산된다. 원래 키워드로는 충분했던 항목들이 새 키워드로는 부족해진다.

    외부 DoFollow 링크(검색엔진에 신뢰를 전달하는 외부 연결)와 내부 링크(같은 사이트 내 다른 글로의 연결), 키워드 밀도(본문에서 특정 키워드가 나오는 비율)를 다시 보강해야 했다.

    본문 문구를 바꿀 때마다 이미지 깨짐 방지 절차도 지켰다. REST API(프로그램 간 통신 방식)로 라이브(실제 서버에 올라간 현재 상태) content.raw를 GET(데이터를 가져오는 요청)해서 그 문자열을 수정하고, PATCH(일부만 수정하는 요청) 직후에 이미지 src를 정규식(특정 패턴을 찾는 코드 표현)으로 전부 뽑아 HEAD 요청(파일이 존재하는지 확인하는 요청)으로 200 응답을 확인했다. 이 절차는 번거롭지만 건너뛰면 이미지가 깨진다. 건너뛰지 않는다.

    최종 결과는 이렇다.

    글 수정 전 점수 수정 후 점수
    클로드 스킬 추천 팩트체크 77 81
    오픈컷 과장분석 70 (한때 66까지 하락) 80
    토큰 절약 팁 79 81
    이미 올린 글 5개에 블로그 키워드 리서치를 거꾸로 적용해봤다 ,  aidojin.com 사례 스크린샷 2

    위는 보강 작업을 끝낸 뒤 오픈컷 글의 실제 랭크매스 에디터 화면이다. 포커스 키워드는 ‘오픈컷’, 점수는 80/100.

    이미 올린 글 5개에 블로그 키워드 리서치를 거꾸로 적용해봤다 ,  aidojin.com 사례 스크린샷 3

    위는 클로드 스킬 추천 글의 실제 랭크매스 에디터 화면이다. 포커스 키워드는 ‘클로드 스킬 추천’, 점수는 81/100.

    블로그 키워드 리서치를 반영한 세 글 모두 80점 이상으로 마무리했다. 오픈컷 글이 제일 손이 많이 갔다.

    검색량 없는 글은 억지로 안 고친다, 판단 기준

    MCP 저장소 검증 글과 유튜브 에이전트 스킬 사기 글은 그대로 뒀다. 검색량이 있는 키워드가 없거나, 있다고 해도 내용과 안 맞았다.

    MCP 저장소 검증 글을 더 자세히 보자. ‘MCP서버’라는 키워드의 네이버 검색량이 340이었다. 숫자만 보면 넣고 싶다. 넣지 않았다. 그 글은 MCP 서버를 추천하는 글이 아니라 특정 저장소 7개를 검증한 글이다. ‘MCP서버’를 제목에 넣으면 클릭베이트(제목으로 클릭을 유도하지만 내용은 다른 것)가 된다.

    ujinify.com 자체도 마찬가지다. ‘CLAUDE.md 정리’나 ‘세션 ID 문제’ 같은 글들은 검색량이 거의 없다. 그렇다고 그 글들이 쓸모없는 건 아니다. 키워드 우선 규칙은 검색량이 있을 때 그걸 놓치지 말자는 거다. 검색량 없는 주제에 키워드를 억지로 끼워 맞추라는 규칙이 아니다.

    블로그 키워드 리서치의 판단 기준은 하나다. 넣었을 때 글의 내용이 그 키워드를 검색한 사람의 기대에 부합하는가. 부합하면 넣는다. 아니면 안 넣는다.

    처음부터 키워드를 보고 쓴 사례는 클로드 스킬 추천 글에서 이미 해봤다. 다음에는 그 과정을 아예 처음부터 기록해볼 생각이다. 뒤늦게 고치는 것보다 처음에 맞추는 게 훨씬 덜 번거롭다는 걸, 이번에 확실히 알았다.

  • 세컨드브레인에 메모리 29개 넣고 클로드 코드로 정리시켜봤다

    세컨드브레인에 메모리 29개 넣고 클로드 코드로 정리시켜봤다

    지난 글에서 옵시디언에 세컨드브레인 금고를 만들고, raw·wiki·output 폴더만 비워둔 채로 끝냈다. “다음 글에서는 raw에 실제 자료를 넣고, Claude Code한테 wiki로 정리하라고 시켜본 결과를 쓸 것”이라고 약속했다. 이번 글이 그 결과다.

    세컨드브레인에 뭘 넣었나

    지어낸 테스트 자료는 쓰고 싶지 않았다. 그래서 Claude Code가 세션마다 쌓아온 진짜 메모리를 썼다. Claude Code는 프로젝트별로 기억해야 할 규칙·결정·진행 상황을 마크다운 파일로 저장해두는데, 이건 평소에 내가 직접 열어볼 일이 없는 폴더다. 세컨드브레인에 꺼내놓으면 처음으로 눈으로 보게 되는 셈이었다.

    전체 74개 메모리 파일 중, 지금 운영 중인 프로젝트 것만 29개를 골라 raw/claude-memory/에 그대로 복사했다. 애드센스 거절로 폐기된 블로그(japanresident.xyz 등) 관련 파일은 뺐다.

    분류 파일 수
    ujinify.com 15개 (글쓰기 규칙, 랭크매스, 애드센스 심사 이력 등)
    숏츠 두 채널 8개 (주제 추천 방식, 이미지 스타일)
    티스토리 3개 (저수익 진단, 주제 전략)
    목표·프로필 3개

    “넣으면 자동으로 정리된다”는 사실이 아니었다

    영상에서는 raw에 넣기만 하면 wiki가 저절로 채워지는 것처럼 보였다. 지난 글에서 “확인 전까지는 단정하지 않겠다”고 썼는데, 이번에 확인했다. 자동으로 되는 기능이 아니다. 옵시디언은 그냥 마크다운 파일이 든 폴더다. raw에 파일을 쌓아둬도 옵시디언이나 Claude Code가 알아서 읽고 wiki에 요약을 쓰는 일은 일어나지 않는다.

    실제로 한 일은 이거다. cd ~/Documents/세컨드브레인으로 그 폴더에서 Claude Code를 켜고, “raw에 복사해 둔 메모리를 wiki에 프로젝트별로 정리해줘”라고 직접 시켰다. 그제서야 29개 파일을 하나씩 읽고, 프로젝트 단위로 묶어서 wiki 노트 4개를 새로 썼다.

    정리된 결과

    wiki 파일 내용
    ujinify.md 글쓰기 워크플로, 하우스 스타일, 랭크매스 규칙, 애드센스 거절 리스크
    tistory.md 사실 왜곡 가드가 왜 필요했는지, 저수익 7단계 진단
    shorts-and-japan-agent.md 숏츠 두 채널 공통 규칙
    monthly-goal.md 월 1만엔 목표와 우선순위

    정리시키면서 알게 된 것

    단순 복사로는 쓸모가 없다. 원본 메모는 사고 하나당 파일 하나라 흩어져 있다. wiki 노트는 “이 프로젝트에서 무슨 일이 있었고 지금 규칙이 뭔지” 흐름으로 다시 써야 한다.

    예를 들어 raw 쪽엔 티스토리 저수익 원인을 다룬 메모가 7단계로 쪼개져 따로따로 있었다. “주제 직접 입력 시 금지 목록 우회 버그 발견”, “362개 글 전수 감사”, “최고위험군 34개 비공개 전환”처럼 사고가 일어난 순서대로 파일이 남아있는 식이다. wiki/tistory.md에는 이걸 “왜 수익이 안 나왔고, 뭘 고쳤고, 지금 몇 개가 비공개인지” 한 문단 흐름으로 다시 썼다. 원본을 그대로 이어붙이면 읽는 사람이 사고 순서를 따라가야 하는데, 다시 쓰면 결론부터 보인다.

    “정리해줘”라고 시킬 때 범위를 먼저 좁혀야 한다. “활성 프로젝트만 넣어라”, “폐기된 건 빼라” 같은 조건을 미리 주지 않으면 필요 없는 것까지 다 끌어온다.

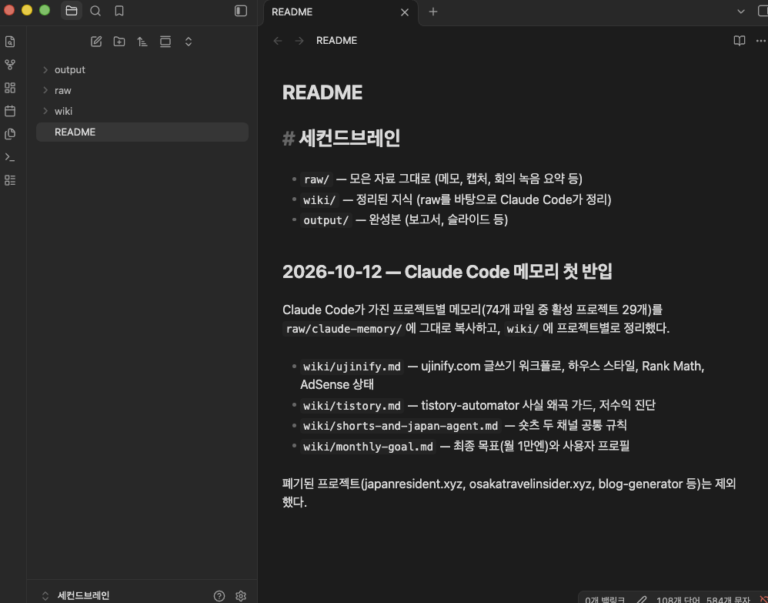
    세컨드브레인 — 옵시디언 금고 README에 raw·wiki·output 구조와 정리 기록이 보이는 화면

    README에 어떤 메모리를 언제 반입했는지 적어뒀다. 글을 쓰다 말고 이전 작업을 까먹지 않으려고 넣은 습관이다.

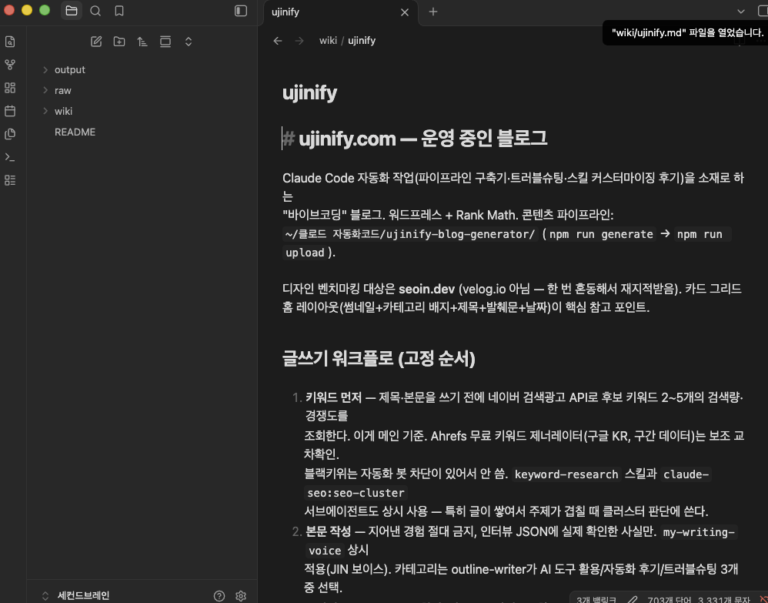
    세컨드브레인 ,  wiki 폴더 안 ujinify 노트, raw 메모리를 프로젝트 단위로 정리한 화면

    wiki/ujinify.md를 연 화면이다. 흩어져 있던 규칙들을 “글쓰기 워크플로”라는 하나의 흐름으로 다시 묶었다.

    세컨드브레인 ,  raw 폴더 안 Claude Code 메모리 원본 파일이 열린 화면

    raw/claude-memory 안에 있는 원본 메모 중 하나다. wiki로 옮기기 전까지는 이런 조각난 파일 형태로만 있었다.

    아직 안 해본 것

    raw가 더 많이 쌓였을 때도 “정리해줘” 한 번으로 되는지는 모른다. 이번엔 29개가 전부라 한 번에 다 읽혔다. 파일이 수백 개가 되면 어떻게 될지는 확인하지 못했다.

    wiki 노트가 최신 상태를 유지하려면 raw가 바뀔 때마다 다시 정리를 시켜야 하는데, 그 주기를 아직 정해두지 않았다. 지금은 raw가 늘어날 때마다 수동으로 “다시 정리해줘”라고 시키는 방법밖에 없다.

    다음엔 메모리 파일 말고 다른 형태의 raw 자료도 넣어볼 생각이다. 예를 들면 예약 발행한 글들의 랭크매스 점수 변화나 GSC 노출 기록처럼, 마크다운이 아니라 숫자·캡처 위주인 자료다. 그런 것도 같은 방식으로 “정리해줘”가 통하는지는 아직 모른다.

    더 읽을거리

    옵시디언 설치와 금고 연결 과정은 지난 글에 정리해뒀다. 옵시디언 사용법, Claude Code 연결까지 실제로 해봤다 그 위에서 이번 작업을 이어갔다. 옵시디언 자체 설명은 obsidian.md에서 볼 수 있다.

    정리

    • 세컨드브레인은 raw에 넣는다고 자동으로 wiki가 채워지지 않는다. 그 폴더에서 Claude Code에게 직접 정리를 시켜야 한다.
    • Claude Code가 가진 프로젝트별 메모리 29개를 raw/claude-memory에 반입하고, 프로젝트 4개 단위로 wiki 노트를 새로 썼다.
    • 단순 복사가 아니라 “무슨 일이 있었고 지금 규칙이 뭔지” 흐름으로 다시 써야 쓸모 있다.
    • raw가 더 쌓였을 때도 같은 방식이 통하는지는 아직 확인 못 했다.
  • 관련 글 카드로 바꾸다 만난 버그 3개, 워드프레스 템플릿 직접 수정기

    관련 글 카드로 바꾸다 만난 버그 3개, 워드프레스 템플릿 직접 수정기

    이번에 손댄 건 글 상세 페이지(single 템플릿)다. 댓글창을 없애고, 관련 글 카드를 넣고, 저자 소개 박스를 추가했다. 작업 방식은 워드프레스 에디터에서 클릭하는 게 아니라 REST API(Application Programming Interface, 프로그램끼리 데이터를 주고받는 창구)로 템플릿 파일을 직접 꺼내서 코드를 고치는 방식이었다. 순서대로 정리한다.

    왜 기본 댓글창을 없앴을까?

    글 하단에 워드프레스 기본 댓글 폼(form, 입력창)이 그대로 붙어 있었다. 문제는 이걸 아무도 쓰지 않는다는 거다. 방문자가 거의 없는 블로그라 댓글이 달린 적이 한 번도 없었다. 빈 입력창이 화면 아래를 한 블록씩 차지하고 있는 셈이었다.

    없애는 건 결정했다. 그 자리에 뭘 넣을지가 문제였다. 고민 끝에 관련 글 카드 그리드로 채우기로 했다. 어차피 그 공간, 뭔가 의미 있는 걸 보여주는 게 낫다.

    REST API로 템플릿 파일을 직접 수정하는 방법

    워드프레스 블록 테마(block theme, 블록 단위로 페이지를 조립하는 방식의 테마)를 쓰면 템플릿 파일이 코드로 저장된다. 이걸 에디터에서 클릭해서 고칠 수도 있지만, 이번엔 REST API를 썼다.

    방식은 단순하다. 먼저 GET 요청(request, 서버에 데이터를 달라고 보내는 신호)으로 현재 템플릿 코드를 통째로 받아온다. 그 코드를 수정한 뒤, POST 요청으로 다시 서버에 올린다. 이번에 건드린 파일은 twentytwentyfive//single(글 상세 페이지 템플릿)과 twentytwentyfive//home(홈 페이지 템플릿) 두 개다.

    수정 전에는 반드시 원본을 백업해둬야 한다. 이건 선택이 아니다. 잘못 올리면 페이지가 깨지고, 원본이 없으면 되돌릴 방법이 없다.

    수정 후에도 주의할 게 있다. 캐시 플러그인인 LiteSpeed가 이전 버전을 그대로 보여주기 때문에, 코드를 올린 뒤 캐시를 반드시 지워야 실제로 반영된다. 이걸 모르면 코드는 바뀌었는데 화면은 그대로라 한참 헤맬 수 있다.

    바뀐 결과는 매번 데스크톱과 모바일 화면을 스크린샷으로 직접 확인했다. 눈으로 봐야 안다.

    관련 글 카드를 만들고 현재 글 중복 버그 고치기

    댓글 블록 자리에 쿼리 루프 블록을 넣었다. 카드 3개짜리 그리드다. 각 카드에는 대표 이미지, 카테고리, 제목, 날짜가 나온다.

    섹션 제목은 처음에 ‘이어서 읽을 글’이라고 썼다. 뉘앙스가 애매했다. ‘함께 보면 좋은 글’로 바꿨다.

    그런데 버그가 두 개 있었다.

    첫 번째. 지금 읽고 있는 글 자신이 관련 글 카드에 그대로 나왔다. 현재 글이 본문 위에도 있고, 아래 카드에도 있는 구조였다. 이건 WPCode 플러그인(코드 스니펫을 워드프레스에 안전하게 추가할 수 있는 도구)으로 PHP 필터를 추가해서 현재 글 ID를 쿼리에서 빼는 방식으로 해결했다.

    두 번째. 글 하단에 예전부터 있던 ‘더 많은 게시물’ 목록이 그대로 살아 있었다. 새로 넣은 카드 바로 아래에 같은 글들이 또 나오는 거다. 이건 그냥 지웠다. 살릴 이유가 없었다.

    카드 추천 로직도 손봤다. 같은 카테고리에 글이 4개 이상 있으면 그 카테고리 안에서만 추천하고, 부족하면 최신 글로 채운다.

    저자 이름 링크가 빈 페이지로 가던 문제 해결

    글 상단에 ‘작성자 JIN’이 표시되는데, ‘JIN’을 클릭하면 워드프레스 기본 작성자 아카이브 페이지인 /author/ujinify/로 이동했다. 그 페이지는 글 목록만 나열하는 화면이었다. 딱히 의미 있는 정보가 없었다.

    해결 방법은 단순했다. 링크를 그냥 껐다. 상단 작성자 표시와 하단 저자 소개 박스, 둘 다 이름에 걸린 링크를 제거했다.

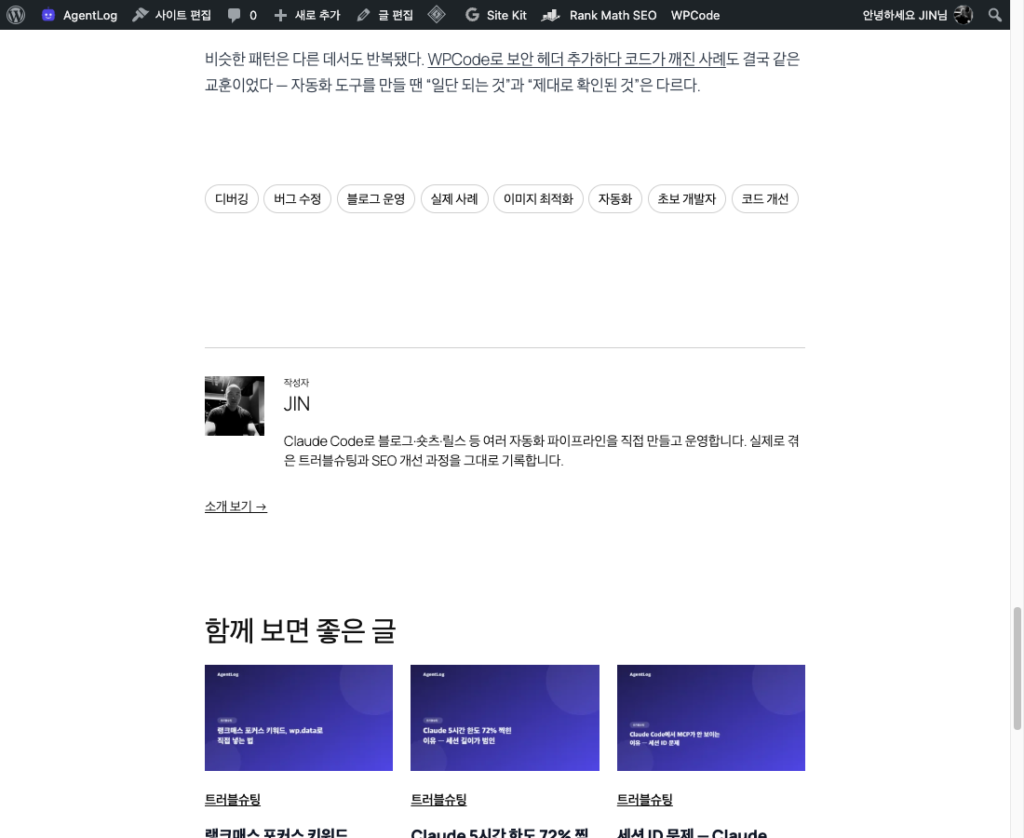
    대신 저자 소개 박스 아래에 ‘소개 보기 →’ 링크를 달았다. /about/ 페이지로 연결된다. 소개가 필요하면 거길 누르면 된다. 저자 박스 구성은 프로필 사진, 이름 ‘JIN’, 짧은 소개 문구, 그리고 그 링크다.

    예전 ‘← 이전 글’ 내비게이션은 지금 읽는 글과 관련 없는 글로 넘어가는 경우가 많아서 클릭할 이유가 없었다. 그 자리를 저자 소개 박스가 대신한다.

    글 하단 저자 소개 박스와 '함께 보면 좋은 글' 카드 섹션 — 댓글창과 이전 글 내비게이션이 있던 자리를 대체한 실제 화면

    위가 완성된 하단 모습이다. 저자 소개 박스 아래로 관련 글 카드 3개가 이어진다. 현재 글 자신은 카드에 안 나온다.

    모바일에서 제목이 이상하게 줄바꿈되는 문제를 CSS로 간단히 고치기

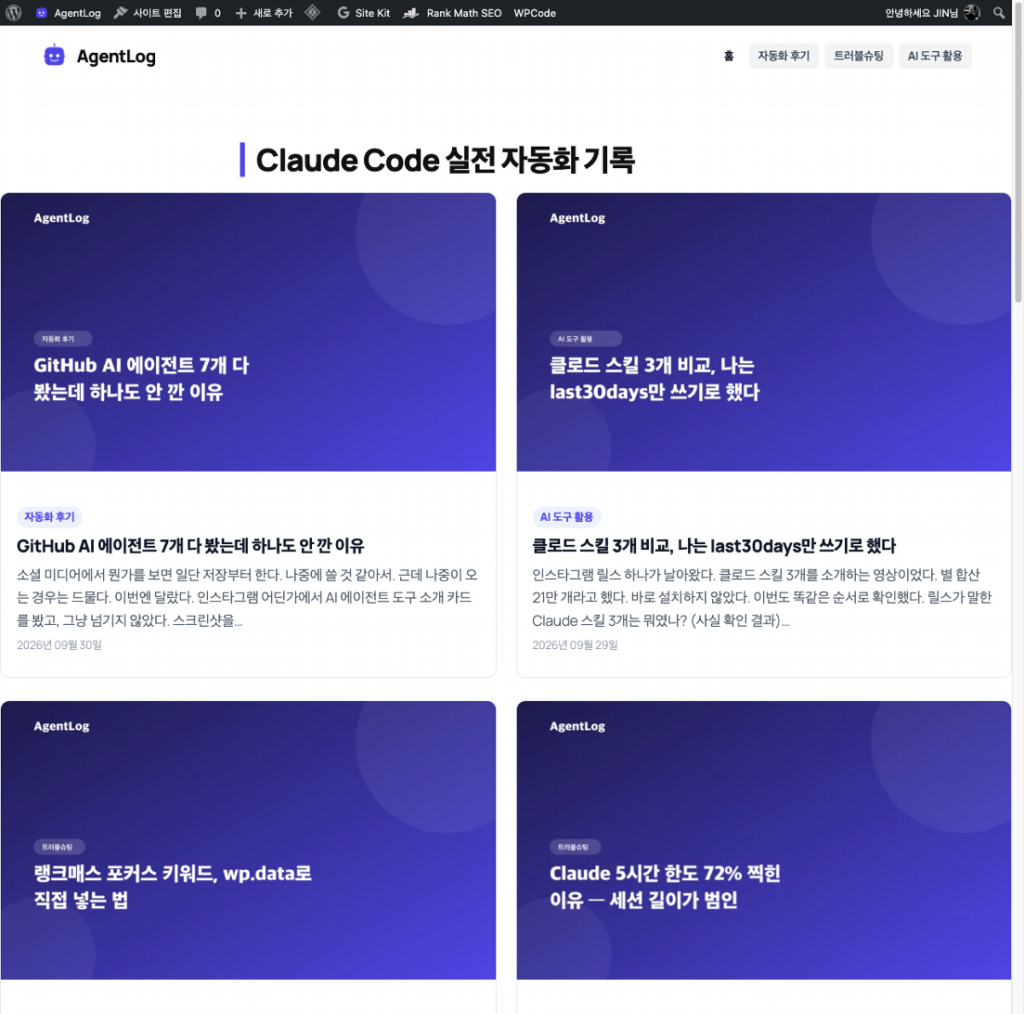
    홈페이지 상단 제목이 원래 ‘블로그’라고만 적혀 있었다. 무슨 블로그인지 설명이 전혀 없었다. ‘Claude Code 실전 자동화 기록’으로 바꿨다.

    홈페이지 데스크톱 화면 ,  '블로그'였던 제목을 'Claude Code 실전 자동화 기록'으로 바꾼 모습

    위가 바뀐 홈 제목의 데스크톱 화면이다.

    제목이 길어지면서 문제가 생겼다. 모바일 화면에서 단어 중간이 잘려서 줄바꿈됐다. 예를 들면 ‘자동화’가 ‘자동’과 ‘화’로 나뉘어서 두 줄에 걸쳐 나오는 식이다. 보기 나빴다.

    처음엔 단어 사이마다 줄바꿈 방지 공백( )을 일일이 넣었다. 동작은 했지만 코드가 지저분했다. 그리고 제목이 바뀔 때마다 또 넣어야 하는 구조였다.

    CSS(Cascading Style Sheets, 웹페이지의 디자인과 레이아웃을 담당하는 언어) 속성 하나로 해결했다.

    • word-break: keep-all , 단어 단위로만 줄바꿈되게 하는 속성이다. 한국어, 중국어, 일본어에 효과적이다.

    속성 하나 추가했더니 공백을 일일이 넣은 코드가 전부 필요 없어졌다. 훨씬 깔끔하다.

    word-break: keep-all 적용 후 모바일 화면 ,  제목이 단어 단위로 자연스럽게 줄바꿈된다

    위는 word-break: keep-all 적용 후 모바일 화면이다. 단어가 잘리지 않고 자연스럽게 줄바꿈된다.

    이번 작업에서 가장 번거로웠던 건 매번 캐시를 지워야 변경이 반영된다는 점이었다. 코드는 올라갔는데 화면이 안 바뀌어서 잠깐 당황한 적도 있었다. 다음엔 REST API 작업 외에 홈 페이지 레이아웃 전체를 손볼 생각이다.

  • GitHub AI 에이전트 7개 다 봤는데 하나도 안 깐 이유

    GitHub AI 에이전트 7개 다 봤는데 하나도 안 깐 이유

    소셜 미디어에서 뭔가를 보면 일단 저장부터 한다. 나중에 쓸 것 같아서. 근데 나중이 오는 경우는 드물다.

    이번엔 달랐다. 인스타그램 어딘가에서 AI 에이전트 도구 소개 카드를 봤고, 그냥 넘기지 않았다. 스크린샷을 찍어서 Claude Code한테 바로 물어봤다.

    AI 에이전트 도구 7개, 먼저 검증했던 이유

    처음엔 3개였다. claude-mem, find-skills, VibeSec. 캡처한 카드를 Claude Code에 던지면서 물었다.

    “지금 설치돼 있어? 설치하면 나한테 좋아? 아니면 없어도 돼?”

    그냥 좋아 보인다고 깔면 안 된다는 걸 안다. 도구는 내 상황에 맞아야 쓸 수 있다. 맞지 않는 도구는 설치하는 순간부터 짐이 된다. 그래서 먼저 확인했다.

    확인 과정에서 ponytail, graphify, Ruflo, OmniRoute까지 추가로 검토하게 됐다. 결국 7개를 다 들여다봤다.

    이미 깔려있던 도구들 (claude-mem, find-skills, ponytail, graphify)

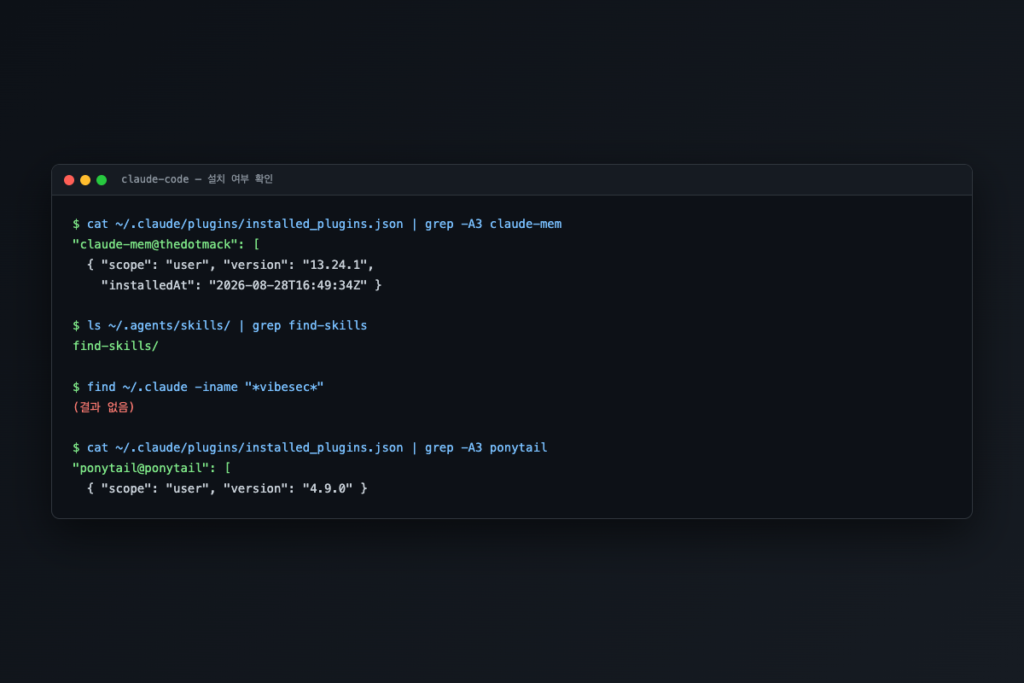
    결과부터 말하면, 4개는 이미 있었다.

    claude-mem은 8월 28일부터 설치돼 있었다. find-skills도 이미 스킬로 등록된 상태였다. 몰랐다. 쓰고 있었는데 쓰고 있는 줄 몰랐던 거다.

    ponytail은 좀 달랐다. 설치돼 있는 수준이 아니었다. 그 대화를 하는 내내 실제로 켜져서 작동하고 있었다. 이걸 확인하면서 뭔가 이해됐다. Claude Code가 항상 최소한의 코드로 답하던 게 이상하다고 생각한 적 있었는데, 그게 ponytail 때문이었다. 도구가 조용히 일하고 있었던 거다.

    graphify도 전역 설정(어떤 프로젝트에서도 공통으로 적용되는 설정)에 등록돼 있어서 언제든 쓸 수 있는 상태였다. fire-your-seo-agency 스킬을 블로그 4개에 자동 적용했을 때도 비슷한 걸 느꼈다 — 이미 깔린 걸 제대로 아는 게, 새로 까는 것보다 먼저다.

    AI 에이전트 도구 claude-mem, find-skills, VibeSec, ponytail 설치 여부를 실제 명령어로 확인한 터미널 화면

    이 네 개는 새로 깔 필요가 없었다. 이미 있으니까.

    VibeSec을 안 깐 이유: 내 프로젝트 구조와 안 맞았다

    VibeSec은 웹 취약점(XSS, SQL 인젝션 같은 것)을 잡아주는 보안 도구다.

    XSS(Cross-Site Scripting)는 악성 스크립트를 웹페이지에 심는 공격이고, SQL 인젝션은 데이터베이스 쿼리를 조작하는 공격이다. 로그인 폼, 검색창, 결제 입력칸 같은 데서 주로 생긴다.

    내 프로젝트엔 그런 게 없다. 지금 만드는 건 블로그 자동 생성 스크립트들이다. 사용자 입력을 받는 곳이 없다. 로그인도 없고 결제도 없다. 워드프레스 인증은 앱 비밀번호를 .env.local 파일(환경 변수를 저장하는 파일, 코드에 직접 비밀번호를 적지 않기 위해 사용)에 넣어서 쓰는 정도다.

    VibeSec이 잡아줄 취약점 자체가 생길 구조가 아니었다. 좋은 도구지만 내 상황엔 맞지 않는다. 그래서 안 깔았다.

    Ruflo, OmniRoute가 과했던 이유

    Ruflo는 스웜 오케스트레이션(swarm orchestration, 여러 AI 에이전트를 동시에 무리 지어 운영하는 방식) 프레임워크다.

    근데 확인해보니 사실 claude-flow라는 기존 프로젝트를 이름만 바꾼 거였다. 버전이 385개나 찍혀 있었다. 60개 넘는 에이전트를 동시에 굴리는 구조인데, 내 작업은 프로젝트마다 4~5개 역할이 정해진 순서대로 도는 방식이다. Ruflo가 필요한 상황이 아니었다. 이름을 바꿨다고 다른 도구가 되는 건 아니다.

    OmniRoute는 다른 방향에서 과했다. 여러 AI 제공사(OpenAI, 앤트로픽 같은 곳)를 하나로 묶어서 무료 할당량을 다 쓰면 자동으로 다른 모델로 넘어가는 게이트웨이(gateway, 여러 서비스를 하나로 연결하는 중간 통로)다.

    아이디어는 나쁘지 않다. 하지만 내 파이프라인 전체가 Claude 하나 기준으로 맞춰져 있다. 말투 스킬도, AI 패턴 차단 규칙도 전부 Claude 기준이다. 여기에 다른 모델을 섞으면 그동안 다듬어온 것들이 다 어긋날 수 있다. 거기다 요청이 게이트웨이를 하나 더 거치게 된다는 것도 마음에 걸렸다. 중간에 거치는 단계가 하나 늘어날 때마다 뭔가 꼬일 가능성도 하나씩 늘어난다.

    13만 개 별을 의심하고 다시 확인한 검증 과정

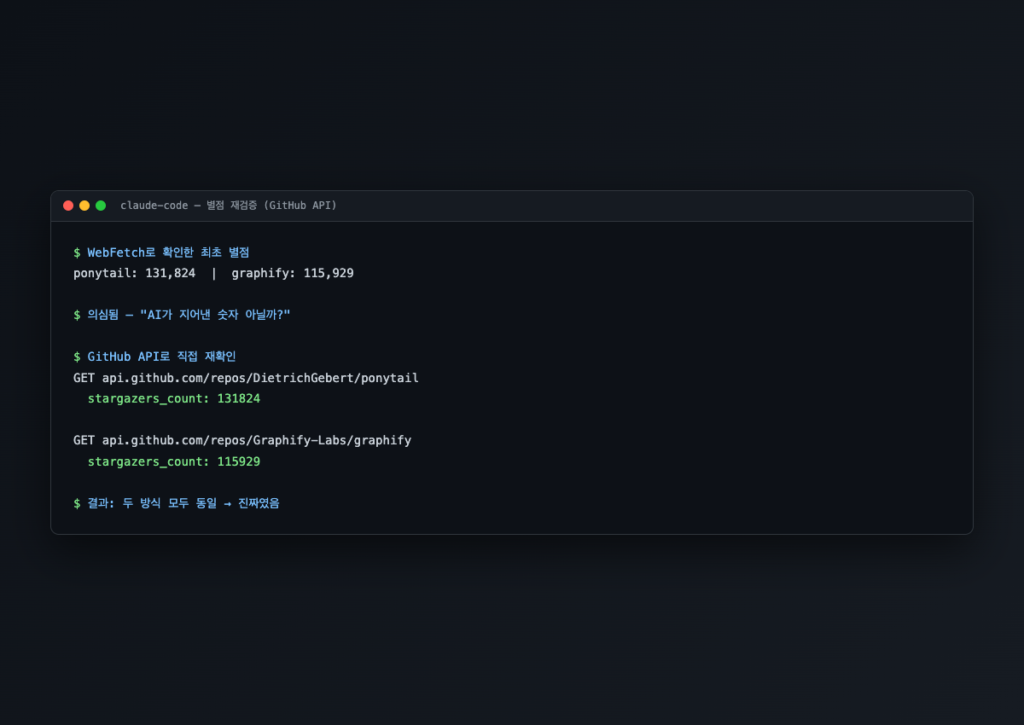
    ponytail 별(star, GitHub에서 사용자들이 좋은 프로젝트에 누르는 즐겨찾기 같은 것)이 13만 개, graphify가 11만 개라고 나왔다.

    이 숫자가 이상했다. 13만 개면 엄청난 숫자다. 유명한 오픈소스 프로젝트 수준이다. AI가 그냥 그럴듯하게 숫자를 지어냈을 수 있다고 생각했다. AI가 할루시네이션을 일으키는 건 알려진 사실이다.

    그래서 GitHub API(Application Programming Interface, 프로그램끼리 데이터를 주고받는 통로)로 직접 다시 확인해달라고 했다. 결과는 같은 숫자였다. 진짜였다.

    AI 에이전트 도구 ponytail과 graphify 별점을 GitHub API로 재검증한 터미널 화면, stargazers_count 값이 동일하게 확인됨

    의심했다. 확인했다. 믿었다. 이 순서가 맞다. 실제로 ponytail 저장소에 들어가면 지금도 그 별점을 직접 확인할 수 있다.

    AI가 말하는 숫자나 사실은 한 번쯤 다시 확인해야 한다. 귀찮더라도 그렇게 해야 한다. 이번엔 맞았지만, 다음에도 맞다는 보장은 없다.

    하나도 안 깐 게 오히려 정답인 이유

    7개를 다 봤다. 하나도 안 깔았다.

    처음엔 뭔가 하나쯤은 새로 깔아야 할 것 같았다. 7개를 다 확인해봤는데 결과물이 없으면 시간 낭비처럼 느껴질 것 같았다. 근데 하나씩 따져보면서 생각이 바뀌었다.

    이미 있는 건 이미 있는 거다. 없는 건 지금 내 상황에 안 맞았다. 새로 깐 게 없다는 게 실패가 아니라, 지금 쓰는 구조가 이미 내 상황에 맞게 다듬어져 있다는 확인이었다.

    뭔가를 안 하기로 결정하는 것도 결정이다. 그리고 그 결정을 내리려면 일단 확인은 해봐야 한다. 소개 카드만 보고 “좋아 보이네” 하고 깔았으면 지금 내 환경에 안 맞는 도구들이 3~4개쯤 더 쌓여 있었을 거다.

    다음엔 지금 이미 깔려 있는 도구들을 제대로 들여다볼 생각이다. ponytail이 그 대화 내내 켜져 있었다는 걸 이번에 처음 알았다. 모르고 쓰고 있는 게 또 있을 거다.

    버전이 안 맞아서 CLI가 아예 안 됐던 사례는 데몬 버전 불일치로 CLI가 안 됐던 이야기 (v1.8.7→1.8.8)에 정리했다.

  • AI 없이 코드로 만든 썸네일 자동 생성 (비용 0원)

    AI 없이 코드로 만든 썸네일 자동 생성 (비용 0원)

    블로그를 운영하다 보면 어느 순간 홈 화면이 이상하게 어수선해 보이는 때가 온다. 나한테는 그게 썸네일이었다.

    스크린샷으로 썸네일을 만들면 뭐가 문제일까?

    처음에는 대수롭지 않게 생각했다. 글 쓰고, 관련 화면 캡처하고, 그걸 대표 이미지로 올리면 끝. 빠르고 간단했다.

    근데 카드가 쌓이면서 문제가 드러났다. 어떤 카드는 흰 배경의 밝은 에디터 화면, 어떤 카드는 어두운 터미널 화면. 톤이 제각각이었다. 여기서 끝이 아니었다. 스크린샷마다 여백 비율이 달랐다. 카드 썸네일로 자르면 내용이 잘리거나 텅 빈 것처럼 보이는 것도 나왔다.

    사용자가 홈 화면을 보고 한마디 했다. “좀 더 깔끔하고 고급스럽게 만들 수 없을까요?” 그 말을 듣고 보니, 스크린샷 짜깁기로는 한계가 명확했다.

    스크린샷 대신 코드로 브랜드 썸네일 자동 생성하기 (AI 크레딧 0원) 스크린샷 1

    위가 당시 실제 홈 화면이다. 카드 하나하나를 따로 보면 그럭저럭 봐줄 만한데, 그리드 전체를 놓고 보면 통일감이 없다.

    AI 이미지 생성이 아닌 코드 합성을 고른 이유

    AI로 이미지를 생성하는 방법도 고려했다. 잠깐 진지하게.

    근데 두 가지 이유로 접었다. 첫 번째는 비용이다. 매 글마다 이미지 생성 API(외부 서버에 요청을 보내 이미지를 만드는 서비스)를 호출하면 글을 쓸 때마다 크레딧이 나간다. 두 번째는 일관성이다. AI 생성 이미지는 프롬프트(AI에게 전달하는 명령 텍스트)가 같아도 매번 스타일이 미묘하게 달라진다. 카드 그리드의 통일감을 위해 썸네일을 바꾸는 건데, AI로 만들면 오히려 통일감이 더 흐트러질 수 있다.

    결론은 단순했다. 제목 텍스트와 카테고리를 코드로 합성(여러 요소를 프로그래밍으로 조합해 이미지를 만드는 것)해서, 항상 똑같은 스타일의 썸네일을 찍어내는 쪽을 고른다. 비용은 0원. 스타일은 항상 동일하다.

    Sharp로 SVG 썸네일을 PNG로 변환하기

    실제 구현 방식은 이렇다. sharp라는 이미지 처리 라이브러리(Node.js 환경에서 이미지를 읽고 변환하고 저장하는 도구)를 사용했다. SVG(코드로 그리는 벡터 이미지 형식)로 썸네일 디자인을 정의하고, 그걸 PNG로 변환하는 구조다.

    캔버스(이미지의 전체 작업 공간) 크기는 1200×675. 16:9 비율이다. 배경은 인디고 계열 그라데이션을 깔았다. 왼쪽 위에는 ‘AgentLog’ 로고 텍스트를 넣고, 그 아래 카테고리 배지, 그리고 글 제목을 크게 배치했다.

    신경 쓴 부분이 두 가지 있었다. 제목이 길면 자동으로 줄바꿈되게 했고, 글자 수에 맞춰 폰트 크기도 줄어들게 처리했다. 제목이 30자짜리 글도 있고 10자짜리 글도 있으니, 이걸 고정 크기로 두면 어디선가 반드시 넘친다.

    제일 걱정한 건 한글 렌더링(화면에 글자를 실제로 그려내는 과정)이었다. SVG 안에서 한글이 깨지거나 이상하게 나오면 처음부터 다시 접근해야 하니까. 테스트해보니 macOS 기본 폰트로 깨짐 없이 잘 나왔다. 이 부분은 솔직히 예상보다 수월했다.

    스크린샷 대신 코드로 브랜드 썸네일 자동 생성하기 (AI 크레딧 0원) 스크린샷 2

    변환 결과물이다. 스크린샷 모음이랑 비교하면 차이가 바로 보인다. 단순하지만 톤이 일정하다.

    워드프레스 API로 기존 글 14개 일괄 처리하기

    새 글에만 적용하면 어색해진다. 예전 글 썸네일은 여전히 스크린샷이고, 새 글 썸네일만 정돈된 디자인이면 오히려 더 눈에 띄게 이상하다.

    그래서 기존 글도 전부 다시 처리했다. 발행된 글 8개, 예약된 글 6개. 총 14개를 한 번에 재생성하는 스크립트(자동으로 반복 작업을 처리하는 코드 파일)를 따로 만들었다.

    흐름은 이렇다. 전에도 REST API로 글 데이터를 직접 다룬 적이 있는데, 이번에도 같은 방식이었다. 워드프레스 REST API(워드프레스가 외부 코드와 데이터를 주고받을 수 있도록 제공하는 통신 창구)로 각 글의 제목과 카테고리를 가져온다. 그 데이터로 썸네일을 생성한다. 생성된 이미지를 미디어 라이브러리(워드프레스에서 이미지, 파일 등을 보관하는 공간)에 업로드하고, 해당 글의 대표 이미지를 갈아끼운다. 14개 전부 한 번에 실행했고, 몇 분 만에 끝났다.

    스크립트 하나로 14개를 처리한다는 게 처음엔 좀 무섭기도 했다. 잘못되면 14개가 동시에 망가지니까. 실행 전에 글 하나만 따로 테스트하고, 결과를 눈으로 확인한 다음 전체를 돌렸다.

    Alt 텍스트까지 한 번에 채우기

    썸네일은 바뀌었는데 문제가 하나 더 있었다. 워드프레스 미디어 라이브러리에 등록된 대체 텍스트(alt text, 이미지를 볼 수 없을 때 대신 읽히는 텍스트로 접근성과 SEO에 영향을 준다)가 비어있었다.

    마침 이 시점에 워드프레스에 새로 생긴 ‘커넥터’ 화면을 발견했다. AI API 키(외부 AI 서비스를 사용하기 위한 인증 코드)를 저장해두는 코어 기능인데, 여기에 연결하면 대표 이미지·대체 텍스트·제목을 AI로 자동 생성해주는 공식 플러그인을 설치할 수 있는 구조였다.

    잠깐 혹했다. 근데 생각해보면 이미 답이 있었다. 썸네일 이미지 안에 들어가는 내용 자체가 글 제목이다. AI를 부를 이유가 없다. 제목 텍스트를 그대로 alt로 넣으면 충분하다. 새 플러그인 설치 없이, 스크립트에 코드 몇 줄 추가하는 것으로 끝났다.

    스크린샷 대신 코드로 브랜드 썸네일 자동 생성하기 (AI 크레딧 0원) 스크린샷 3

    미디어 라이브러리에서 alt 텍스트가 채워진 상태다. 간단한 해결이었는데, 찾는 데 오히려 시간이 걸렸다.

    배포할 때 실제로 주의할 점

    이 작업을 따라 해보려는 사람이 있다면, 몇 가지는 반드시 미리 알고 시작해야 한다.

    • 글 하나만 먼저 테스트해라. 14개를 한 번에 돌리기 전에 반드시 글 하나에만 스크립트를 적용하고 결과를 확인해야 한다. 일괄 처리 스크립트는 잘못될 경우 피해 규모도 일괄이다.
    • 기존 썸네일을 먼저 백업해라. 미디어 라이브러리에서 원본 이미지를 지우지 마라. 대표 이미지만 갈아끼우고 기존 파일은 남겨두면, 문제가 생겼을 때 되돌릴 수 있다.
    • API 인증 정보를 코드 안에 직접 쓰지 마라. 워드프레스 REST API를 쓰려면 사용자 이름과 애플리케이션 비밀번호(Application Password, 워드프레스에서 API 접근용으로 따로 발급하는 비밀번호)가 필요하다. 이 값은 .env 파일(환경 변수를 따로 저장하는 설정 파일)에 넣고, 절대 GitHub(코드를 공개 저장하는 플랫폼) 같은 곳에 올리지 마라.
    • 폰트 문제는 환경마다 다르다. macOS에서 한글이 잘 나왔다고 서버에서도 잘 나온다는 보장이 없다. 리눅스 서버 환경에서 자동화할 계획이라면 폰트 파일을 따로 지정하는 방식을 써야 한다.

    참고로 이 썸네일, 글 상세 페이지에서는 다른 비율로 잘려서 나온 적이 있었다. 이미지 생성 코드는 멀쩡했는데 템플릿 설정이 문제였다.

    이번 작업을 끝내고 나서 하나 다시 확인한 게 있다. 새로운 기능이 필요할 때 플러그인이나 유료 API부터 찾는 건 좋은 습관이 아니다. 이미 가진 데이터로 해결되는지 먼저 따져봐야 한다. alt 텍스트가 그랬다. AI를 부르기 직전에 “잠깐, 제목이 이미 있잖아”라는 생각 하나로 불필요한 의존성이 사라졌다.

    다음에는 썸네일 디자인 자체에 변화를 줘볼 생각이다. 카테고리별로 배경색을 다르게 주는 방식. 지금은 전부 인디고 단색인데, 카테고리가 시각적으로 구분되면 홈 화면의 카드 그리드가 한 번 더 정돈될 것이다. 아직 확신은 없다. 일단 해봐야 안다.

  • 예약 발행 기능을 직접 만들고 4개 글을 한 번에 올린 후기

    예약 발행 기능을 직접 만들고 4개 글을 한 번에 올린 후기

    예약 발행 기능이 없어서 매번 이렇게 됐다. 월요일 아침마다 똑같은 일을 반복하고 있었다. 글 하나 급하게 다듬고, 올리고, 끝. 그게 매주였다.

    왜 그때그때 올리는 방식에 불만을 느꼈을까?

    문제는 비효율이었다. 월요일이 될 때마다 그날 올릴 글 하나를 챙기는 방식은 솔직히 별로였다. 한 번 집중해서 여러 편을 미리 써뒀는데, 그걸 굳이 하나씩 날짜 맞춰 손으로 올려야 한다는 게 이상했다.

    그래서 방향을 바꿨다. 한 주치 분량을 미리 정해두고, 날짜에 맞춰 자동으로 나가게 하는 구조가 낫다고 판단했다. 어느 월요일 아침, Claude Code에 바로 요청했다. “이번 주 수요일, 토요일, 다음 주 수요일, 토요일. 4개 예약 발행 하고 싶은데 가능해?”

    가능하지 않았다.

    예약 발행 기능이 없다면 직접 만들어야 한다

    업로드 스크립트(script, 자동으로 실행되는 명령어 묶음)에는 예약 발행 기능 자체가 없었다. 초안(draft, 공개 전 임시 저장 상태)으로 올리는 것만 됐다. 특정 날짜에 자동으로 글이 나가도록 하는 옵션은 아예 존재하지 않았다.

    당연히 있을 거라고 생각했다. 없어서 좀 당황스럽긴 했지만! 근데 어쩔 수 없다. 이것 역시 내가 지금까지 겪었던 것처럼 없으면 만들면 된다.

    그 자리에서 바로 Claude Code에 추가 구현을 요청했다. 기존 스크립트를 고쳐서 날짜를 지정하면 그 시각에 발행되도록 하는 옵션을 넣는 작업이었다.

    –schedule 옵션을 추가한 과정

    Claude Code에게 요청한 방향은 단순했다. 기존 업로드 스크립트에 --schedule 옵션(option, 명령어를 실행할 때 추가로 붙이는 설정값)을 새로 추가해 달라는 것이었다. 날짜를 함께 넘기면 해당 시각에 발행되는 구조다.

    예를 들어 이런 식이다.

    • 기존 방식: 스크립트를 실행하면 바로 발행되거나 초안으로 저장
    • 추가된 방식: --schedule 2025-07-09처럼 날짜를 붙이면 그 날짜에 자동 발행

    Claude Code가 기존 코드 구조를 파악하고 옵션을 붙이는 로직(logic, 기능이 작동하는 규칙과 흐름)을 추가했다. 내가 직접 코드를 짠 게 아니다. 요청했고, 결과를 확인했다. 그게 전부였다.

    기능 자체는 복잡하지 않았다. 처음부터 있었어야 했다고 생각한다.

    4개 글을 한 번에 처리하려면 기준을 낮춰야 현실적이다

    SEO(Search Engine Optimization, 검색엔진 최적화) 점수 기준 얘기를 해야 한다. 평소에는 랭크매스 기준 80점을 맞추고 올렸다.

    이번엔 달랐다. 한 번에 4개를 처리해야 했다. 4개 전부 80점을 맞추려고 시간을 쓰다 보면 예약 발행의 의미가 없어진다. 그래서 기준을 낮췄다. 70점 이상이면 올린다고 정했다.

    Claude Code에 요청할 때도 명확하게 전달했다. “랭크매스는 70점 이상만 맞춰줘.” 완벽하게 다듬는 것보다 4개를 제때 내보내는 게 이번의 목표였다.

    기준을 낮추는 게 맞냐 틀리냐의 문제가 아니다. 현실적인 선택이었다. 한 번에 처리하는 분량이 늘어나면 기준도 거기에 맞게 조정해야 한다. 그렇지 않으면 결국 아무것도 못 올린다.

    실제로 예약 발행을 돌려본 결과

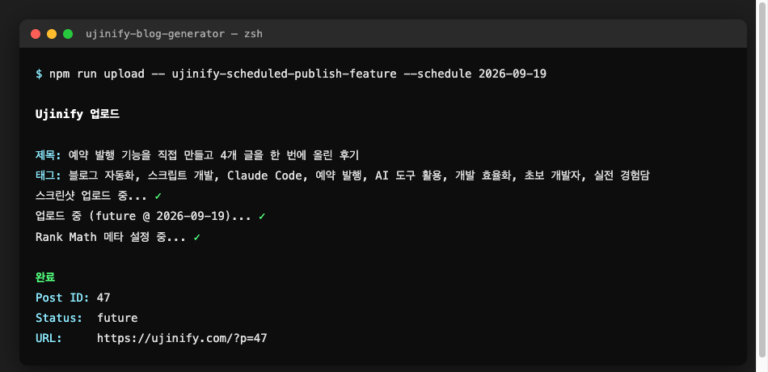
    4개 글을 한 번에 예약 걸었다. 이번 주 수요일, 토요일, 다음 주 수요일, 토요일. 각각 날짜를 지정해서 스크립트를 돌렸다.

    예약 발행 기능을 만들어서 4개 글을 한 번에 예약한 실제 화면

    작동했다. 상태가 “future”로 바뀌면서 예약이 정상적으로 걸린 걸 확인했다. 이제 지정한 날짜가 되면 자동으로 발행된다. 월요일 아침에 급하게 뭔가를 챙기는 일은 없어졌다.

    다만 솔직히 말하면, 70점 기준으로 올린 글들이 80점짜리보다 성과가 어떻게 다를지는 아직 모른다. 데이터가 쌓여야 안다. 지금은 그냥 지켜보는 중이다.

    예약 발행 자체는 앞으로도 유지할 생각이다. 그때그때 올리는 방식으로는 안 돌아간다. 미리 묶어서 처리하는 게 훨씬 낫다. 다음엔 4개가 아니라 더 늘릴 수 있을지 한번 봐야겠다.

  • 블로그 자동 크로스포스팅, 알아보고 완전 보류한 이유

    블로그 자동 크로스포스팅, 알아보고 완전 보류한 이유

    자동 크로스포스팅, 편하면 좋겠다고 생각한 게 시작이었다. ujinify.com 글이 올라갈 때마다 레딧과 X에도 같이 뿌려지면 손이 덜 갈 것 같았다.

    편하려던 것 하나로 시작했는데…

    ujinify.com에 글을 올릴 때마다 레딧이랑 X에도 자동으로 같이 올라가면 어떨까. 그런 생각이 들었다. 그래서 Claude Code(AI 코딩 도우미)한테 바로 물어봤다. 지금 블로그에 글을 업로드하면 레딧이나 X에도 자동 업로드되게 할 수 있냐고.

    Claude Code는 가능하다고 했다. 근데 “가능하다”는 말이 끝이 아니었다. 확인해야 할 게 줄줄이 나왔다.

    먼저 뭐부터 확인해야 할까? (API 키 체크)

    API 키(API key, 외부 서비스를 코드로 사용할 때 필요한 비밀번호 같은 값)부터 확인했다. 이미 가지고 있으면 바로 붙일 수 있으니까.

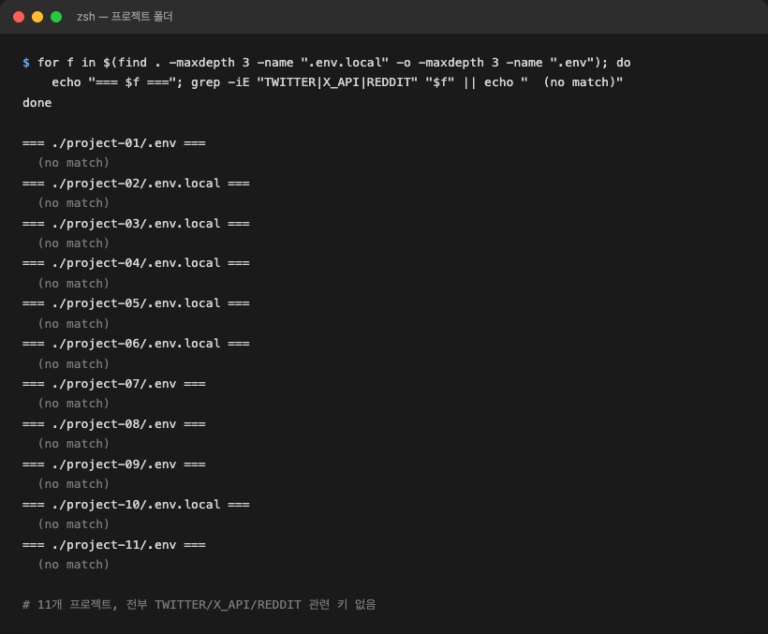
    내가 쓰는 프로젝트 폴더(project folder, 하나의 작업 단위로 묶인 파일 모음)가 11개다. 블로그, 숏츠, 릴스 관련 작업들이 각각 분리돼 있다. 각 폴더 안에 있는 .env, .env.local 파일(환경변수 파일, API 키 같은 민감한 값을 저장해두는 설정 파일)을 전부 뒤졌다. TWITTER, X_API, REDDIT 관련 키워드로 전부 검색했다.

    결과는 깔끔했다. 하나도 없었다.

    처음부터 앱을 새로 등록하고 키를 발급받아야 하는 상황이었다. 그 순간부터 “이게 정말 해볼 만한 건지”를 다시 따져보기 시작했다.

    프로젝트 폴더 11개의 .env 파일을 전부 검색해 레딧·X API 키가 없는 것을 확인한 터미널 화면

    위 화면이 실제로 11개 프로젝트 폴더를 뒤진 결과다. 관련 키가 하나도 없는 걸 직접 확인했다.

    X 크로스포스팅, 요금이 생각보다 깐깐했다

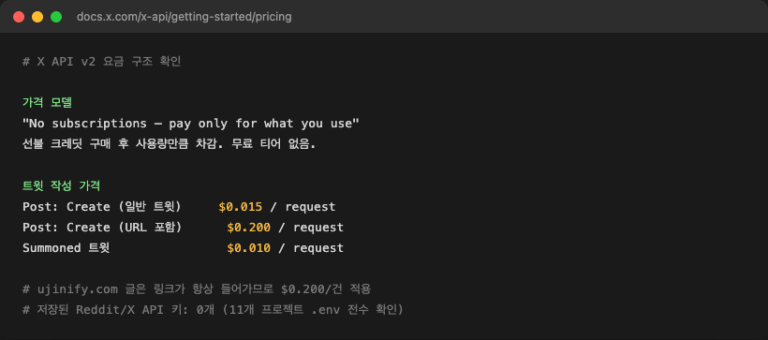
    X(구 트위터) API(Application Programming Interface, 외부 서비스 기능을 코드로 연결하는 통로) 공식 요금 페이지를 확인했다. 무료 티어(tier, 등급)가 있겠거니 했다. 없었다.

    구독제도 아니다. 완전 종량제(사용한 만큼만 요금을 내는 방식)다. 구조는 이렇다.

    트윗 유형 건당 요금
    일반 트윗 $0.015
    링크 포함 트윗 $0.200

    문제는 내 블로그 글에는 항상 링크가 들어간다는 거다. 크로스포스팅이라는 게 결국 블로그 링크를 X에 올리는 일이니까, 건당 $0.200이 적용된다.

    한 달에 8개 올린다고 치면 $1.6. 그렇게 보면 큰돈은 아니다. 근데 매번 돈이 나가는 구조라는 게 확인됐다. 자동화를 붙인다는 건 이 비용이 쌓인다는 뜻이다. 올리는 글이 늘어날수록 같이 늘어난다.

    레딧이 더 무섭다: 계정 정지의 위험성

    레딧 API는 개인용 소규모 스크립트라면 무료로 열려 있다고 한다. 돈 문제가 아니다.

    진짜 문제는 계정 정지다.

    레딧의 거의 모든 서브레딧은 자기 홍보 링크 비율을 엄격하게 제한한다. 흔히 말하는 10분의 1 법칙 같은 게 있다. 홍보 아닌 글 9개당 홍보 글 1개 정도만 허용된다는 기준이다.

    기계적으로 같은 도메인 링크를 반복 게시하면 스팸 필터에 걸린다. 계정이 아예 밴될 수 있다. 자동 크로스포스팅은 이 패턴을 정확하게 만들어낸다.

    ujinify.com 글 올릴 때 레딧·X에 자동 크로스포스팅 하고 싶었는데, 알아보고 나서 완전 보류로 정했다 스크린샷 2

    실제로 Claude Code와 이 리스크를 확인하는 과정에서 나온 내용이다. 기술적으로 가능하다는 것과, 해도 된다는 건 다른 문제였다.

    기존에 쌓아온 신뢰도가 한 번에 깎인다는 걸 알다

    이 부분이 가장 크게 와닿았다.

    지금까지 레딧이나 네이버 지식iN에 백링크 작업을 할 때는 직접 했다. 관련 질문 스레드를 직접 찾아서, 맥락에 맞게, 조심스럽게 답변을 달았다. 그렇게 쌓은 신뢰도가 있다.

    자동 크로스포스팅을 붙이면 그게 한 번에 깎인다. 방향이 완전히 반대다.

    신경 써서 만들어온 계정 신뢰도를 자동화 스크립트 하나가 스팸 계정으로 만들 수 있다. 그걸 알고 나니 선택지가 명확해졌다.

    최종 결정: 완전 보류로 정한 이유

    보류했다. 완전히.

    X는 기술적으로는 된다. 근데 건당 비용이 계속 나간다. 레딧은 API보다 계정 정지 위험이 훨씬 크다. 두 채널 다 지금 당장 붙일 이유가 없었다.

    지금 우선순위는 두 가지다. 애드센스 승인, 그리고 ujinify.com 자체 SEO(Search Engine Optimization, 검색엔진 최적화, 검색 결과 상위에 노출되게 만드는 작업) 노출이다. 여기에 자동 크로스포스팅을 얹는 건 도움보다 리스크가 크다.

    나중에 블로그가 어느 정도 자리를 잡으면 그때 다시 검토한다. 계정 신뢰도가 충분히 쌓이고, 수동으로도 어느 정도 커뮤니티 활동이 된 뒤에. 지금은 아니다.

    편하려고 시작한 건데, 알아볼수록 지금은 하지 않는 게 맞다는 결론이 나왔다. 그게 이번 조사의 결과다.

    기술적으로 되는 것과, 지금 해도 되는 것은 다른 질문이다. 이번에 자동 크로스포스팅을 알아보면서 그 차이를 제일 크게 배웠다. 앞으로도 새 자동화를 붙이기 전에는 비용과 리스크부터 먼저 따지기로 했다.

    크로스포스팅 대신 먼저 만든 예약 발행 기능은 예약 발행 기능을 직접 만들고 4개 글을 한 번에 올린 후기에 정리했다.

  • Claude Code로 UI 재설계하면서 배운 AI 협업 꿀팁과 함정

    Claude Code로 UI 재설계하면서 배운 AI 협업 꿀팁과 함정

    Claude Code 사용법을 실전에서 익혔다. Claude Code로 블로그 UI를 처음 손봤다. 홈 화면 재설계, 스크롤 목차, 로봇 로고 브랜딩까지 한꺼번에 작업했다. 빠르지 않았다. 하지만 혼자 했으면 못 끝냈을 작업을 끝냈다.

    Claude Code 사용법, UI를 직접 만들어보니 어땠나?

    Claude Code는 AI(인공지능) 기반 코딩 도구다. 터미널(terminal, 텍스트로 컴퓨터에 명령을 내리는 창)에서 명령어를 치면, AI가 코드를 직접 읽고 수정하고 실행까지 해준다. 에디터(editor, 코드를 작성하는 프로그램)를 오가며 복사 붙여넣기 할 필요가 없다.

    이번에 작업한 항목은 세 가지였다. 홈 화면 레이아웃(layout, 화면 구성 방식) 재설계, 글 목록을 따라다니는 스크롤 목차, 그리고 블로그 로고 교체. 규모가 작지 않았다.

    Claude Code로 홈 화면 카드 그리드 재설계, 스크롤 따라다니는 목차, 로봇 로고+파비콘까지 브랜딩 다시 한 후기 스크린샷 1

    재설계를 마친 지금 홈 화면이다. 글 목록이 카드 그리드로 정리됐다.

    처음엔 속도가 붙는 느낌이었다. “홈 화면 카드 간격 늘려줘”, “목차 위치 고정해줘” 같은 말만 해도 AI가 코드를 찾아서 고쳐줬다. 근데 작업이 길어질수록 문제가 생기기 시작했다.

    텍스트 안 보임, 위치 계산 오류… 실제로 마주친 버그들

    제일 시간을 잡아먹은 버그는 두 가지였다. 텍스트가 안 보이는 문제, 그리고 요소(element, 화면을 구성하는 개별 블록) 위치 계산 오류.

    텍스트가 안 보이는 건 CSS(Cascading Style Sheets, 화면의 색상·크기·위치를 정하는 코드) 문제였다. 배경색이랑 글자색이 같아져버리는 식이다. 눈에 안 보이니까 버그인지도 한참 몰랐다. 위치 계산 오류는 더 번거로웠다. 스크롤 목차가 엉뚱한 곳에 붙거나, 화면 밖으로 튀어나갔다.

    Claude Code로 홈 화면 카드 그리드 재설계, 스크롤 따라다니는 목차, 로봇 로고+파비콘까지 브랜딩 다시 한 후기 스크린샷 2

    새로 만든 헤더다. 로봇 로고와 카테고리 메뉴가 나란히 붙었다.

    이런 버그들은 Claude Code한테 증상을 설명하면 고쳐줬다. 완전히 못 고친 건 아니다. 다만 시간이 걸렸다. “텍스트가 안 보여”라고 말하면 원인을 찾고, 수정하고, 다시 확인하는 과정을 반복해야 했다. 빠른 척하지만 한 번에 되는 경우는 드물었다.

    모르는 버그가 더 있을 수 있다는 것도 문제다. 눈에 보이는 버그는 고칠 수 있다. 눈에 안 보이는 버그는 존재 자체를 모른다.

    AI가 기억을 못 하는 문제에 대처한 방법

    이게 진짜 스트레스였다.

    Claude Code는 대화 맥락이 길어지면 앞에서 한 말을 잊는다. 정확히는 잊는다기보다 우선순위가 밀린다. 내가 “이 스타일은 건드리지 마”라고 했어도, 나중에 다른 수정을 요청하면 그 스타일을 다시 바꿔놓는 경우가 생겼다.

    더 황당한 경우도 있었다. 내가 특정 레퍼런스를 요청했는데, AI가 그걸 무시하고 자기가 찾은 걸 벤치마킹해버렸다. 내 요구사항이 아니라 AI가 판단한 방향으로 가버린 거다. 이건 버그인지 특성인지도 모르겠다.

    Claude Code로 홈 화면 카드 그리드 재설계, 스크롤 따라다니는 목차, 로봇 로고+파비콘까지 브랜딩 다시 한 후기 스크린샷 3

    글을 스크롤하면 옆에 목차가 따라다니고, 지금 읽고 있는 항목이 강조 표시된다.

    그래서 이렇게 대처했다.

    • 작업 단위를 작게 쪼개야 한다. 한 번에 많은 걸 요청하면 맥락이 흔들린다.
    • 중요한 조건은 매 요청마다 반복해서 명시해야 한다. 한 번 말했다고 AI가 기억한다고 믿지 마라.
    • AI가 자의적으로 바꾼 부분이 없는지 결과물을 꼭 직접 확인해야 한다. 확인 없이 넘어가면 나중에 더 꼬인다.
    • 레퍼런스를 요청할 때는 URL(인터넷 주소)이나 구체적인 예시를 함께 줘야 한다. 막연하게 “이런 느낌으로”는 AI 마음대로 해석된다.

    궁극적으로는 버그를 스스로 찾아서 고치는 AI를 원하는데, 지금 Claude Code는 거기까지는 못 간다. 내가 발견한 것만 고친다. 이 한계는 명확히 알고 써야 한다.

    로봇 로고를 선택한 이유: AI 시대를 표현하다

    로고를 바꿨다. 이전 로고 얘기는 길게 안 한다. 중요한 건 왜 로봇으로 바꿨냐는 거다.

    지금이 AI 시대다. 이 블로그도 AI 도구를 활용하는 내용을 다룬다. 그걸 가장 직관적으로 보여주는 이미지가 로봇이라고 판단했다. 복잡한 이유는 없다.

    Claude Code로 홈 화면 카드 그리드 재설계, 스크롤 따라다니는 목차, 로봇 로고+파비콘까지 브랜딩 다시 한 후기 스크린샷 4

    최종적으로 정한 로봇 로고 아트웍이다.

    스타일 방향은 Claude Code가 몇 가지 후보를 제안했고, 그중에서 로봇 아이콘을 직접 골랐다. AI 시대를 표현하는 데 제일 직관적인 이미지라고 판단했다. 지금 보니 잘 고른 것 같다.

    로고 작업 자체는 다른 버그들에 비해 순탄했다. 방향이 명확하면 AI도 잘 따라온다. 방향이 흐릿할 때 문제가 생긴다.

    완성 후 느낀 점: 완벽함보다는 계속된 개선이 정답

    버그 때문에 시간은 오래 걸렸다. 하지만 완성은 했다.

    완성된 걸 보고 “완벽하다”는 생각은 안 들었다. 완성인지 미완성인지도 솔직히 아직 모른다. 지금은 만족스럽다. 근데 계속 쓰다 보면 만족스럽지 못한 부분이 또 나올 거다. 그게 당연한 과정이다.

    Claude Code로 홈 화면 카드 그리드 재설계, 스크롤 따라다니는 목차, 로봇 로고+파비콘까지 브랜딩 다시 한 후기 스크린샷 5

    워드프레스에 등록된 로봇 파비콘이다. 브라우저 탭에 이렇게 뜬다.

    지금은 계속 사용하면서 버그를 잡고 있다. 더 유용한 기능이나 플러그인이 있는지도 알아보는 중이다. Claude Code도 계속 쓰면서 어떻게 하면 더 잘 쓸 수 있는지 파악하고 있다.

    AI 도구는 만능이 아니다. 기억을 못 하고, 자의적으로 판단하고, 눈에 안 보이는 버그는 그냥 둔다. 그걸 알고 쓰는 것과 모르고 쓰는 건 결과가 다르다. 다음 작업은 이번에 파악한 한계를 기준으로 접근할 생각이다.

    워드프레스 템플릿을 직접 고친 다른 사례는 관련 글 카드로 바꾸다 만난 버그 3개, 워드프레스 템플릿 직접 수정기에도 있다.

  • Claude Code 7개 에이전트로 블로그 자동화 파이프라인 만들기

    Claude Code 7개 에이전트로 블로그 자동화 파이프라인 만들기

    블로그 자동화 파이프라인, 이번에 직접 만들어봤다.

    블로그 글 하나를 쓰려면 생각보다 손이 많이 간다. 인터뷰 정리하고, 개요 짜고, 본문 쓰고, 표현 다듬고, 워드프레스에 올리고. 이 과정을 자동화하면 어떨까 싶었다.

    Claude Code로, 에이전트(agent, 특정 역할을 맡아 자동으로 작업하는 AI) 7개를 동원해서.

    결과는 반반이다.

    Subagent-Driven Development, 7개 에이전트가 한 프로젝트를 나눠 맡았다

    이번 프로젝트에서 쓴 방식의 이름이 있다. Subagent-Driven Development, 줄여서 SDD다.

    개념은 단순하다. 하나의 큰 작업을 태스크(task, 작은 단위의 할 일) 여러 개로 쪼개고, 각 태스크를 완전히 새로운 서브에이전트(subagent, 특정 태스크만 담당하는 하위 AI)한테 맡긴다.

    서브에이전트는 자기한테 주어진 태스크만 구현한다. 전체 맥락을 모른다. 그냥 시킨 것만 한다.

    구현이 끝나면 리뷰어 서브에이전트가 따로 붙는다. 리뷰어는 두 가지를 본다.

    • 스펙(spec, 무엇을 만들어야 하는지 적은 명세서)과 구현이 일치하는가
    • 코드 품질은 괜찮은가

    이 두 가지를 별도로 검사한다. 한꺼번에 보지 않는다. 역할을 나눠야 각자 더 잘 본다는 논리다.

    이렇게 하는 이유가 있다. AI 에이전트 하나한테 처음부터 끝까지 다 맡기면 컨텍스트 윈도우가 터진다.

    코드가 길어질수록 앞에 있던 내용을 잊어버린다. 태스크를 잘게 쪼개면 각 에이전트는 자기 몫만 처리하면 된다. 컨텍스트 부담이 준다.

    블로그 자동화 파이프라인 ujinify-blog-generator, 인터뷰에서 게시물까지

    만든 것의 이름은 ujinify-blog-generator다. 파이프라인이라고 부른다. 입력에서 출력까지 단계가 정해져 있으니까.

    흐름은 이렇다.

    • 실제 인터뷰 데이터(질문-답변 형식)를 입력으로 넣는다
    • 그걸 바탕으로 개요를 자동으로 짠다
    • 개요를 가지고 본문을 쓴다
    • AI 티가 나는 표현을 자연스럽게 고쳐쓴다
    • 완성된 글을 워드프레스에 자동으로 업로드한다

    이 각 단계가 태스크 하나씩이다. 총 7개의 태스크, 7개의 서브에이전트. 인터뷰를 넣으면 게시물이 나온다. 적어도 설계는 그랬다.

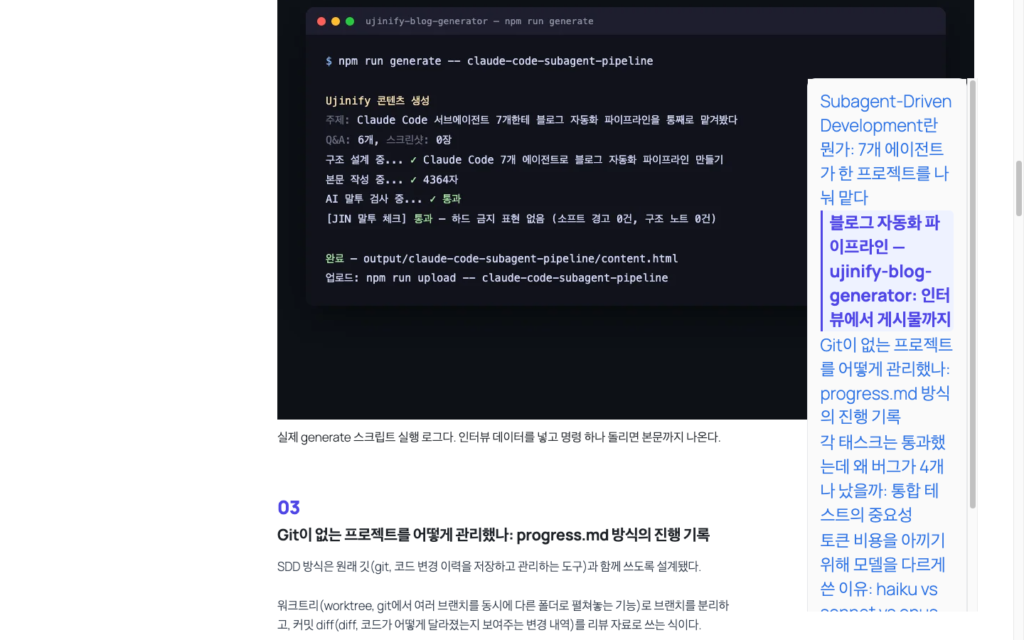
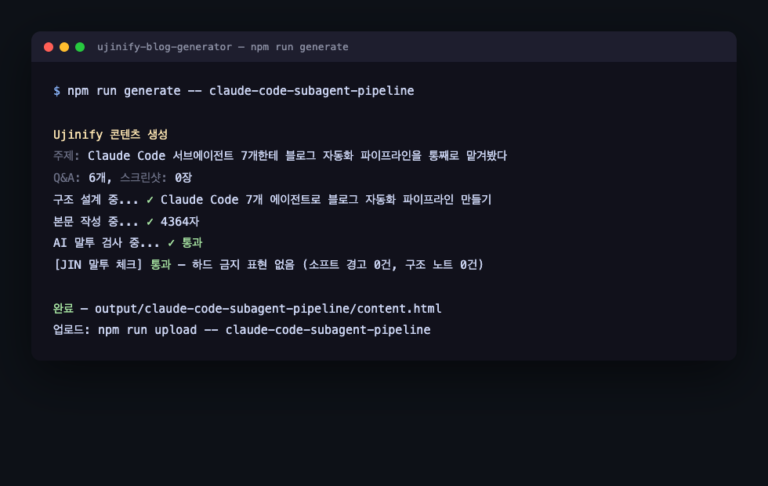
    블로그 자동화 파이프라인 실행 결과 — npm run generate 터미널 로그
    실제 generate 스크립트 실행 로그다. 인터뷰 데이터를 넣고 명령 하나 돌리면 본문까지 나온다.

    Git 없이 진행 상황을 관리한 방법, progress.md

    SDD 방식은 원래 깃과 함께 쓰도록 설계됐다.

    워크트리(worktree, git에서 여러 브랜치를 동시에 다른 폴더로 펼쳐놓는 기능)로 브랜치를 분리하고, 커밋 diff를 리뷰 자료로 쓰는 식이다.

    그런데 이 프로젝트는 git 저장소가 아니었다. 그러니까 그 방식을 그대로 못 썼다.

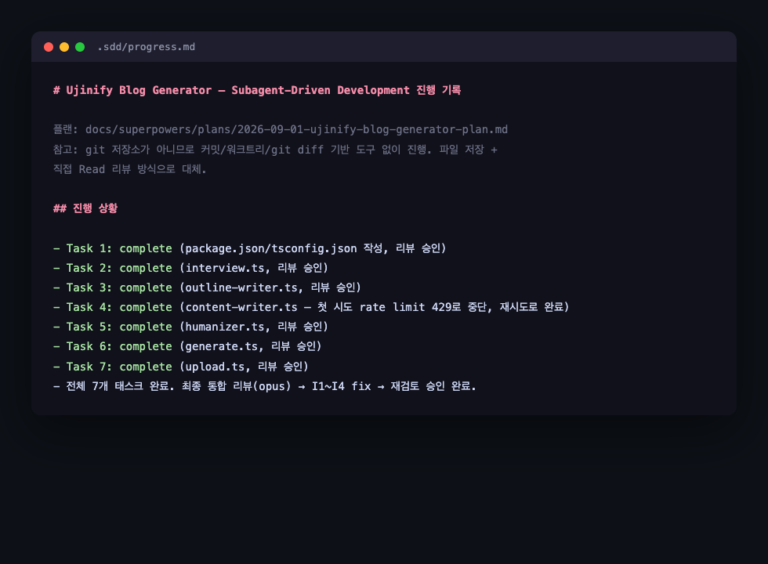
    해결책은 단순하게 잡았다. .sdd/progress.md라는 파일 하나를 만들고, 거기에 진행 상황을 계속 기록했다.

    태스크가 끝날 때마다 업데이트했다. 리뷰어 에이전트한테는 diff를 주는 대신, 실제 파일을 직접 읽게 했다.

    우아한 방식은 아니다. 그냥 작동했다. 그게 목적이었으니까 됐다.

    .sdd/progress.md 파일에 기록된 7개 태스크 진행 상황, 각 태스크의 완료 상태와 리뷰 승인 여부가 표시된 실제 파일 화면
    git 없이 진행 상황을 추적하려고 직접 만든 progress.md 기록.

    각 태스크는 통과했는데 버그가 4개 났다, 통합 테스트의 중요성

    7개 태스크, 7번의 리뷰. 전부 통과했다.

    그래서 다 됐다고 생각했다. 아니었다.

    마지막에 오퍼스로 전체를 한 번 더 통합 리뷰(integration review, 부분이 아닌 전체를 한꺼번에 검토하는 것)했다.

    그랬더니 버그가 4개 나왔다. 각 태스크 리뷰를 전부 통과한 코드에서.

    어떤 버그였냐면:

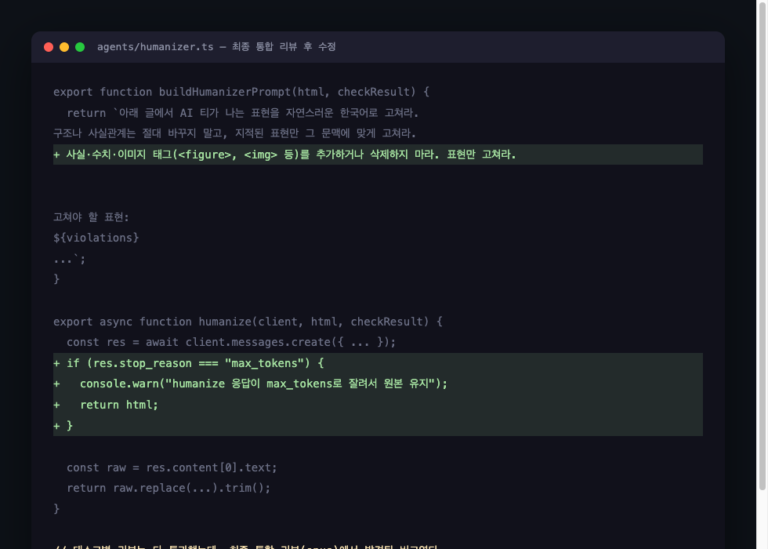
    • AI가 문장을 자연스럽게 고쳐쓰는 단계에서 스크린샷 태그가 조용히 사라질 수 있는 문제
    • AI 응답을 파싱할 때 값이 비어 있어도 그냥 넘어가고, 나중에 업로드 단계에서 크래시가 나는 문제
    • 응답이 중간에 잘려도 아무 체크 없이 그대로 사용할 뻔한 문제

    태스크 리뷰가 이 버그들을 못 잡은 이유

    태스크 리뷰에서 이게 안 잡힌 이유는 명확하다. 각 태스크 리뷰는 “이 태스크 브리프와 구현이 일치하는가”만 본다.

    태스크 2에서 만든 값이 태스크 5에서 어떻게 쓰이는지는 태스크 2 리뷰어가 알 수 없다. 구조적으로 못 본다.

    이건 SDD 방식의 한계다. 태스크를 잘게 쪼갤수록 각 리뷰의 시야도 좁아진다.

    통합 테스트(integration test, 여러 부분을 합쳤을 때 전체가 제대로 동작하는지 확인하는 테스트)는 별도로 반드시 해야 한다. 태스크 리뷰가 다 통과했다는 말은 전체가 괜찮다는 말이 아니다.

    humanizer.ts 코드에서 최종 통합 리뷰 후 추가된 버그 수정 코드 두 군데가 초록색으로 강조 표시된 실제 diff 화면
    태스크 리뷰는 다 통과했지만, 최종 통합 리뷰에서 발견돼 나중에 추가한 안전장치.

    토큰 비용을 아끼기 위해 모델을 다르게 쓴 이유: haiku vs sonnet vs opus

    Claude 모델은 종류가 여러 개다. 그리고 비싸기도 다 다르다.

    모델 역할 이유
    haiku 각 태스크 구현 가장 저렴하다. 반복 작업에 쓴다.
    sonnet 태스크별 리뷰 중간 성능, 중간 가격. 리뷰는 구현보다 판단력이 필요하다.
    opus 최종 통합 리뷰 가장 비싸다. 전체를 한 번만 본다.

    논리는 단순하다. 비싼 모델을 모든 단계에 다 쓰면 비용이 선형으로 올라간다. 7개 태스크 구현에 opus를 쓸 필요가 없다.

    단순한 구현은 haiku로 충분하다. 판단이 필요한 리뷰는 sonnet을 쓴다. 가장 넓은 시야가 필요한 통합 리뷰에만 opus를 한 번 쓴다.

    역할에 맞는 모델을 쓰는 것. 이게 비용 관리의 핵심이다. 무조건 좋은 모델을 쓰는 게 답이 아니다.

    실제로 겪은 좌절과 배운 점: 자동화의 한계와 현실적인 조언

    솔직하게 쓴다.

    만들면서 헛된 꿈을 꿨다. 이걸로 수익을 벌 수 있을 거라는 생각. 지금 생각하면 웃긴다.

    애드센스 승인도 받지 않은 상태에서 수익을 먼저 계산했다. 순서가 완전히 틀렸다.

    중간에 4번 태스크 구현하다가 API 레이트리밋(rate limit, API를 너무 자주 호출하면 일시적으로 막히는 것, 에러 코드 429)에 걸려서 멈췄다.

    이건 잠깐 기다렸다가 재시도하니까 풀렸다. 그나마 간단한 문제였다.

    더 힘든 건 따로 있었다. 버그가 계속 나오는데, 고치면 또 나오고.

    토큰은 토큰대로 쓰고, 사용량은 사용량대로 올라가는데 결과물은 내 마음대로 안 됐다.

    다 그만두고 싶다는 생각을 몇 번이나 했다. 한두 번이 아니었다.

    버그보다 힘들었던 건 거절 메일이었다

    그때 심사 중이던 다른 애드센스 블로그에서 메일이 왔다. ‘가치가 별로 없는 콘텐츠’라는 이유로 불승인. 그거 보고 진짜로 힘이 빠졌다. ‘내가 지금 뭘 하고 있는 건가’ 싶었다.

    그래서 배운 건 이렇다.

    • 자동화는 반복 작업을 줄여준다. 판단을 대신해주지는 않는다.
    • 태스크 리뷰가 통과됐다고 끝이 아니다. 통합 테스트는 별도로 해야 한다.
    • 수익을 먼저 생각하지 마라. 콘텐츠 승인부터 받아라. 순서가 있다.
    • 버그가 계속 나오는 건 과정이다. 이상한 게 아니다. 그냥 고쳐야 한다.

    블로그 자동화 파이프라인은 일단 완성됐다. 다음 할 일은 정해져 있다. 일단 애드센스 신청 조건부터 다시 읽어볼 생각이다. 자동화 도구보다 그게 먼저다.

    참고로 크로스포스팅 자동화도 고려했었다. 근데 여러 이유로 결국 보류했다. 그 판단 과정은 이 글에 따로 정리해놨다.

    이 블로그를 왜 시작했는지는 소개 페이지에 더 적어놨다.

    예약 발행 기능을 따로 만든 과정은 예약 발행 기능을 직접 만들고 4개 글을 한 번에 올린 후기에 적어뒀다.