Claude API

  • AI 블로그 자동화, 경쟁 글 분석 기능 테스트 7개 통과시켰다

    AI 블로그 자동화, 경쟁 글 분석 기능 테스트 7개 통과시켰다

    AI 블로그 자동화 파이프라인을 돌리면서도, 정작 경쟁 글 구조는 한 번도 체계적으로 분석한 적이 없었다. 글을 잘 쓰는 것과 검색에 상위 노출되는 것은 다른 문제다.

    그 사실을 알면서도 나는 꽤 오랫동안 내 경험만 믿고 글 구조를 짰다. 경쟁자가 뭘 쓰는지는 봤지만, 그들이 어떤 흐름으로 소제목을 배치하는지는 한 번도 체계적으로 분석하지 않았다.

    AI 블로그 자동화에 왜 남의 글 구조를 참고해야 할까 (그 글들이 상위 노출된 이유)

    상위 노출된 글은 우연히 거기 있지 않다. 검색 알고리즘(검색 시스템이 글의 품질을 평가하는 방식)이 그 글을 좋다고 판단했거나, 독자들이 오래 머물렀거나, 두 가지가 동시에 일어난 것이다.

    내 블로그 자동화 파이프라인(pipeline, 여러 작업을 순서대로 연결한 처리 흐름)에는 outline-writer.ts라는 에이전트(agent, 특정 임무를 수행하는 AI 프로그램 단위)가 있었다.

    이 에이전트는 내가 제공한 인터뷰, 즉 실제 경험 데이터만 보고 글의 구조를 짰다. 네이버 검색 키워드는 미리 조사해서 넣었다. 여기까지는 괜찮았다.

    문제는 그다음이었다.

    같은 키워드로 구글과 네이버에 실제로 어떤 글이 뜨는지, 그 글들이 소제목을 어떤 순서로 배치하는지, 키워드를 어느 위치에 박아 넣는지 — 이걸 전혀 참고하지 않았다. 검색 의도(사용자가 검색할 때 실제로 원하는 정보)를 무시한 채 구조를 짠 셈이다.

    상위 노출 글의 구조는 그 자체가 데이터다. 베끼자는 게 아니다. 어떤 흐름이 먹히는지 확인하자는 것이다.

    경쟁 글 분석 에이전트를 따로 만든 이유 (구조만, 문장은 절대 아니)

    가장 먼저 정해야 할 선이 있었다. 구조를 참고하는 것과 문장을 베끼는 것은 완전히 다르다. 저작권 문제를 떠나서, 남의 문장을 그대로 가져오면 내 글이 될 수 없다.

    AI 블로그 자동화를 에이전트 하나가 다 떠맡게 하고 싶지 않았다. 그래서 새 에이전트를 따로 만들었다. agents/competitor-analyzer.ts다.

    이 에이전트가 하는 일은 하나다.

    경쟁 글에서 제목, 소제목(H2) 흐름, 키워드 배치 위치만 뽑아내는 것. 본문 문장은 가져오지 않는다. 이 제약을 코드 레벨이 아니라 프롬프트(AI에게 주는 지시문) 레벨에서 명확하게 걸었다.

    왜 outline-writer에 기능을 얹지 않고 에이전트를 새로 만들었을까. 역할이 다르기 때문이다.

    분석과 집필은 분리해야 나중에 고치기 쉽다. 하나의 에이전트가 두 가지 일을 동시에 하면, 문제가 생겼을 때 어디서 틀렸는지 찾기 어려워진다.

    web_search 도구로 상위 글 2~3개를 찾아 JSON으로 뽑기

    구현은 AI 블로그 자동화 파이프라인에서 이 부분이 핵심이다. 앤트로픽 SDK(소프트웨어 개발 키트, AI 기능을 코드에서 쓸 수 있게 해주는 도구 묶음)의 web_search 서버 도구를 사용했다.

    주제와 관련된 구글 상위 글 2~3개를 찾고, 거기서 구조 정보만 JSON(JavaScript Object Notation, 데이터를 구조화해서 저장하는 텍스트 형식)으로 추출하는 방식이다.

    모델(AI 엔진)은 claude-haiku-4-5를 썼다. outline-writer와 같은 모델이다. 여기서 한 가지 막히는 부분이 있었다.

    web_search 도구에는 두 가지 변형이 있는데, 동적 필터링(검색 조건을 더 세밀하게 조절하는 기능)을 지원하는 최신 버전인 web_search_20260209는 claude-haiku-4-5에서 쓸 수 없었다.

    기본형인 web_search_20250305만 지원됐다. 중간에 알게 돼서 맞췄다.

    pause_turn 처리와 결과물

    또 하나 신경 써야 했던 부분이 있다. 검색 도중 stop_reason(AI가 응답을 멈춘 이유)이 pause_turn으로 끊기는 경우가 생겼다.

    AI가 검색 결과를 받아오는 도중에 중간에 멈추는 현상이다. 이 경우를 처리하기 위해 최대 3번까지 재시도하는 루프를 넣었다.

    AI 블로그 자동화 파이프라인이 실제로 쓰는 데이터는 이거다. 각 경쟁 글마다 제목, H2 소제목 목록, 키워드가 등장하는 위치를 JSON 형태로 정리한 구조 데이터다. 문장은 없다. 뼈대만 있다.

    아래는 테스트가 전부 통과한 시점의 캡처다.
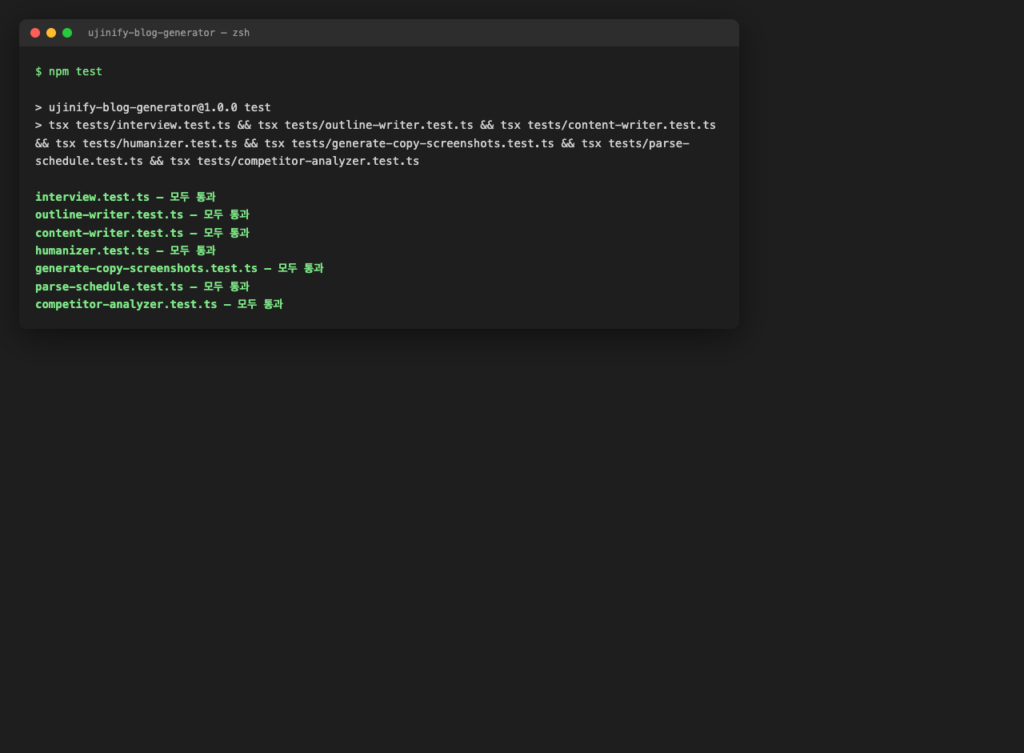
    AI 블로그 자동화 경쟁 글 분석 에이전트 테스트 7개 통과 터미널 캡처

    7개 테스트 파일이 모두 초록불이다. competitor-analyzer.test.ts가 새로 추가된 파일이다.

    outline-writer에 분석 결과를 선택적으로 연결하는 방법

    AI 블로그 자동화 파이프라인에서 분석과 집필을 분리한 이유가 여기서 드러난다.

    competitor-analyzer.ts가 뽑아낸 JSON 결과를 outline-writer.ts에 그냥 던져주면 안 된다. 선택적으로 연결해야 한다.

    outline-writer.ts는 이 분석 결과를 선택적 인자로 받는다.

    분석 결과가 있으면 프롬프트 안에 포함되고, 없으면 기존 방식대로 동작한다. 여기서 프롬프트 문구가 중요하다. 단순히 데이터를 붙여 넣는 게 아니라, 이런 문구를 명시한다.

    참고용 , 절대 베끼지 말고 어떤 흐름이 먹히는지만 참고

    이 한 줄이 없으면 AI는 경쟁 글의 소제목을 그대로 가져올 수 있다. 지시를 명확하게 줘야 한다.

    파이프라인 전체 흐름에서 이 단계의 위치는 이렇다. 인터뷰 데이터를 로드하고 나서, outline을 생성하기 전에 경쟁 글 분석 단계를 끼워 넣었다.

    generate.ts가 이 순서를 관리한다. 순서가 바뀌면 의미가 없다. 분석 결과가 outline보다 먼저 나와야 참고가 된다.

    인스타 숏폼에서 배운 ‘훅’과 ‘피크엔드’ 원칙을 프롬프트에 녹이기

    같은 날 인스타 릴스 영상을 하나 봤다.

    릴스 기획을 AI한테 시키는 방법을 설명하는 영상이었다. 숏폼 영상 기획 공식 세 가지를 소개했다. 도입 3초 훅, 결말 피크엔드 법칙, 중간 반전.

    릴스에서 본 걸 그대로 믿지 않고 AI 블로그 자동화 작업에 가져오기 전에 직접 검증해보는 건 이전에도 한 적이 있다.

    이 중 두 가지는 텍스트 블로그에도 쓸 수 있었다. 나머지 하나는 못 썼다.

    화면 방향 전환이나 다음 영상으로 유도하는 클리프행어는 영상 전용 요소다. 텍스트에 옮기는 건 억지다. 그래서 뺐다.

    가져온 두 가지는 이것이다.

    • 인지 부조화 훅 , 도입부에서 서로 어울리지 않는 개념을 나란히 붙이거나, 독자가 예상하지 못한 사실을 먼저 던져서 궁금증을 만든다. 읽고 싶게 만드는 첫 문장이다.
    • 피크엔드 법칙 , 결론을 흐지부지 요약하지 않는다. 글에서 가장 중요한 성과나 숫자를 마지막에 다시 한번 짚으며 끝낸다. 사람은 절정과 마지막 순간을 가장 선명하게 기억한다.

    프롬프트에 실제로 반영한 곳

    이 두 원칙을 프롬프트 문구로 만들어서 두 군데에 넣었다.

    outline-writer.ts에는 제목 작성 지침과 마지막 소제목 지침에 반영했다. content-writer.ts에는 첫 문단 작성 지침과 결론 지침에 반영했다.

    아래는 outline-writer.ts와 content-writer.ts 프롬프트에 지침이 추가된 코드 캡처다.
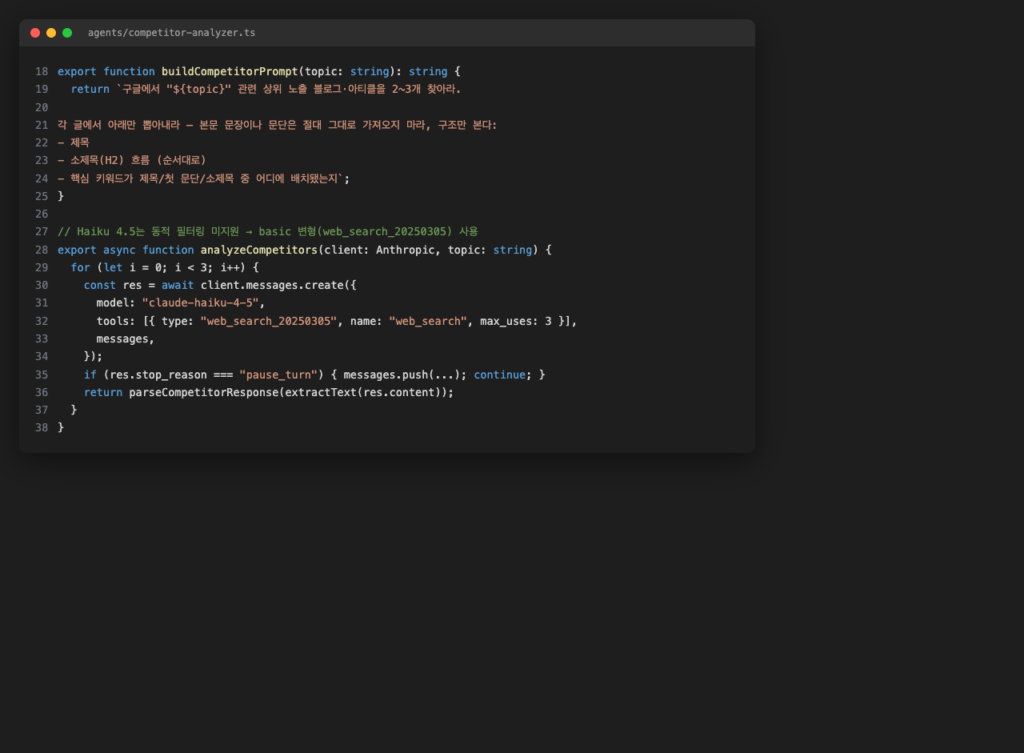
    AI 블로그 자동화 competitor-analyzer.ts 코드 ,  web_search 도구와 pause_turn 재시도 루프

    텍스트로 적혀 있는 지침이지만, AI가 이 문구를 받으면 실제로 첫 문단과 결론을 다르게 쓴다.

    5가지 테스트 케이스로 검증하고, 실전 테스트는 아직 남았다

    AI 블로그 자동화 기능 하나를 추가했다고 테스트를 건너뛸 수는 없다. 코드를 짜고 나서 바로 테스트를 작성했다. competitor-analyzer.test.ts다. 확인한 케이스는 다섯 가지다.

    • 프롬프트 안에 주제와 ‘그대로 가져오지 말라’는 제약 문구가 실제로 들어가는지
    • 정상적인 JSON 응답이 제대로 파싱되는지
    • posts 필드(데이터 항목)가 없을 때 빈 배열로 폴백되는지
    • 검색 결과가 아예 없을 때도 posts: []로 정상 처리되는지
    • 응답 앞뒤에 “검색해보겠습니다” 같은 설명 텍스트가 붙어도 JSON만 정확히 추출되는지

    테스트는 통과했지만, 실전은 아직

    npm test를 실행했다. 기존 6개 테스트 파일에 새 파일이 더해져 총 7개 파일이 전부 통과했다.

    솔직하게 적어야 하는 부분이 있다. 코드와 테스트는 끝났다.

    하지만 실제로 npm run generate를 돌려서 경쟁 글 분석 결과가 실전 outline에 얼마나 잘 반영되는지는 아직 확인하지 않았다. 실행 결과를 본 적이 없다. 이 부분은 모른다.

    테스트 통과와 실전 동작은 다르다. 이건 늘 그렇다. 코드가 맞아도 AI의 실제 출력이 기대와 다를 수 있다. 그걸 확인하는 것이 다음 단계다.

    이번 작업에서 실제로 이뤄진 것은 이것이다.

    경쟁 글 구조를 자동으로 분석하는 에이전트 1개 추가, 테스트 케이스 5개 작성, 총 7개 테스트 파일 전부 통과. 코드와 테스트는 여기까지 증명했다.

    그런데 outline-writer가 이 분석 결과를 실제 글쓰기에 얼마나 반영할지는 아직 모른다. npm run generate를 처음 돌렸을 때, 결과물이 기대와 같을까 다를까.
  • Claude Code 7개 에이전트로 블로그 자동화 파이프라인 만들기

    Claude Code 7개 에이전트로 블로그 자동화 파이프라인 만들기

    블로그 자동화 파이프라인, 이번에 직접 만들어봤다.

    블로그 글 하나를 쓰려면 생각보다 손이 많이 간다. 인터뷰 정리하고, 개요 짜고, 본문 쓰고, 표현 다듬고, 워드프레스에 올리고. 이 과정을 자동화하면 어떨까 싶었다.

    Claude Code로, 에이전트(agent, 특정 역할을 맡아 자동으로 작업하는 AI) 7개를 동원해서.

    결과는 반반이다.

    Subagent-Driven Development, 7개 에이전트가 한 프로젝트를 나눠 맡았다

    이번 프로젝트에서 쓴 방식의 이름이 있다. Subagent-Driven Development, 줄여서 SDD다.

    개념은 단순하다. 하나의 큰 작업을 태스크(task, 작은 단위의 할 일) 여러 개로 쪼개고, 각 태스크를 완전히 새로운 서브에이전트(subagent, 특정 태스크만 담당하는 하위 AI)한테 맡긴다.

    서브에이전트는 자기한테 주어진 태스크만 구현한다. 전체 맥락을 모른다. 그냥 시킨 것만 한다.

    구현이 끝나면 리뷰어 서브에이전트가 따로 붙는다. 리뷰어는 두 가지를 본다.

    • 스펙(spec, 무엇을 만들어야 하는지 적은 명세서)과 구현이 일치하는가
    • 코드 품질은 괜찮은가

    이 두 가지를 별도로 검사한다. 한꺼번에 보지 않는다. 역할을 나눠야 각자 더 잘 본다는 논리다.

    이렇게 하는 이유가 있다. AI 에이전트 하나한테 처음부터 끝까지 다 맡기면 컨텍스트 윈도우가 터진다.

    코드가 길어질수록 앞에 있던 내용을 잊어버린다. 태스크를 잘게 쪼개면 각 에이전트는 자기 몫만 처리하면 된다. 컨텍스트 부담이 준다.

    블로그 자동화 파이프라인 ujinify-blog-generator, 인터뷰에서 게시물까지

    만든 것의 이름은 ujinify-blog-generator다. 파이프라인이라고 부른다. 입력에서 출력까지 단계가 정해져 있으니까.

    흐름은 이렇다.

    • 실제 인터뷰 데이터(질문-답변 형식)를 입력으로 넣는다
    • 그걸 바탕으로 개요를 자동으로 짠다
    • 개요를 가지고 본문을 쓴다
    • AI 티가 나는 표현을 자연스럽게 고쳐쓴다
    • 완성된 글을 워드프레스에 자동으로 업로드한다

    이 각 단계가 태스크 하나씩이다. 총 7개의 태스크, 7개의 서브에이전트. 인터뷰를 넣으면 게시물이 나온다. 적어도 설계는 그랬다.

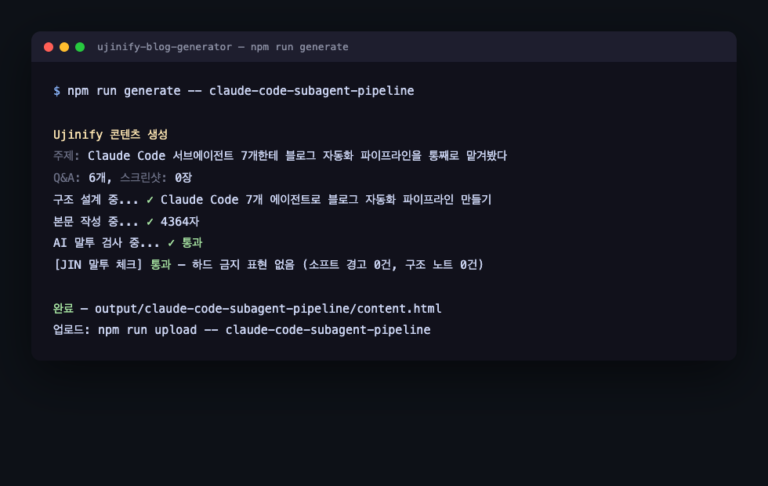
    블로그 자동화 파이프라인 실행 결과 — npm run generate 터미널 로그
    실제 generate 스크립트 실행 로그다. 인터뷰 데이터를 넣고 명령 하나 돌리면 본문까지 나온다.

    Git 없이 진행 상황을 관리한 방법, progress.md

    SDD 방식은 원래 깃과 함께 쓰도록 설계됐다.

    워크트리(worktree, git에서 여러 브랜치를 동시에 다른 폴더로 펼쳐놓는 기능)로 브랜치를 분리하고, 커밋 diff를 리뷰 자료로 쓰는 식이다.

    그런데 이 프로젝트는 git 저장소가 아니었다. 그러니까 그 방식을 그대로 못 썼다.

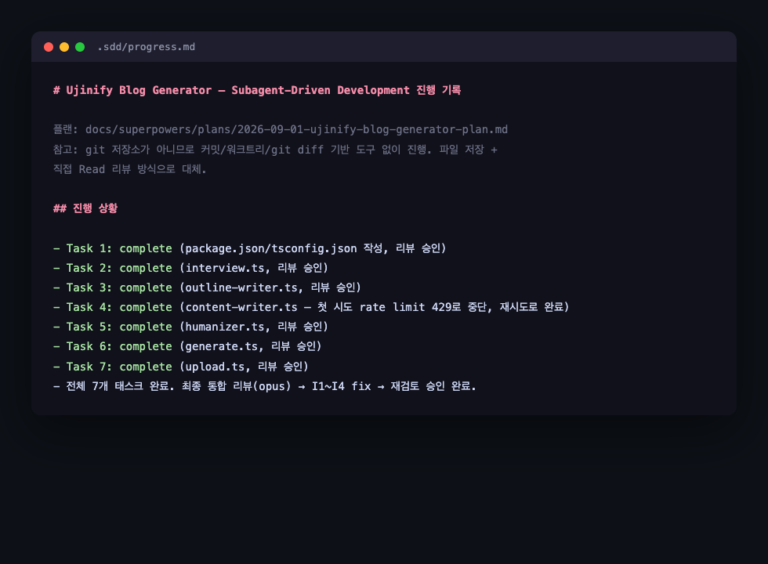
    해결책은 단순하게 잡았다. .sdd/progress.md라는 파일 하나를 만들고, 거기에 진행 상황을 계속 기록했다.

    태스크가 끝날 때마다 업데이트했다. 리뷰어 에이전트한테는 diff를 주는 대신, 실제 파일을 직접 읽게 했다.

    우아한 방식은 아니다. 그냥 작동했다. 그게 목적이었으니까 됐다.

    .sdd/progress.md 파일에 기록된 7개 태스크 진행 상황, 각 태스크의 완료 상태와 리뷰 승인 여부가 표시된 실제 파일 화면
    git 없이 진행 상황을 추적하려고 직접 만든 progress.md 기록.

    각 태스크는 통과했는데 버그가 4개 났다, 통합 테스트의 중요성

    7개 태스크, 7번의 리뷰. 전부 통과했다.

    그래서 다 됐다고 생각했다. 아니었다.

    마지막에 오퍼스로 전체를 한 번 더 통합 리뷰(integration review, 부분이 아닌 전체를 한꺼번에 검토하는 것)했다.

    그랬더니 버그가 4개 나왔다. 각 태스크 리뷰를 전부 통과한 코드에서.

    어떤 버그였냐면:

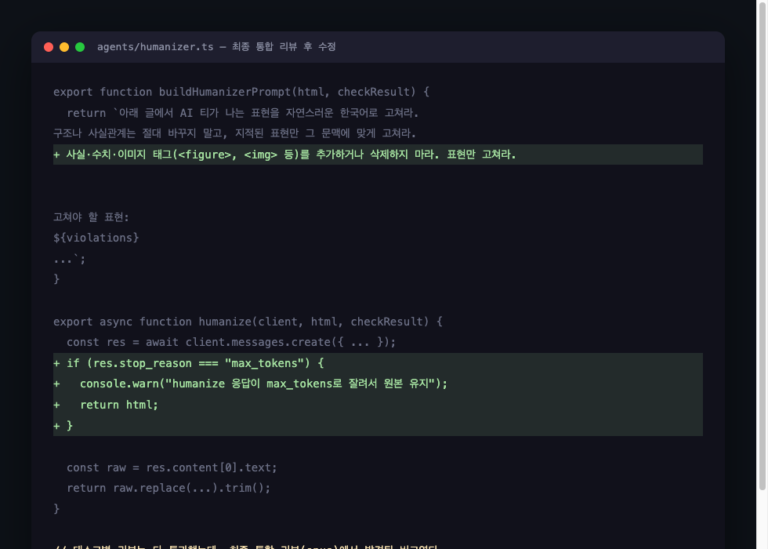
    • AI가 문장을 자연스럽게 고쳐쓰는 단계에서 스크린샷 태그가 조용히 사라질 수 있는 문제
    • AI 응답을 파싱할 때 값이 비어 있어도 그냥 넘어가고, 나중에 업로드 단계에서 크래시가 나는 문제
    • 응답이 중간에 잘려도 아무 체크 없이 그대로 사용할 뻔한 문제

    태스크 리뷰가 이 버그들을 못 잡은 이유

    태스크 리뷰에서 이게 안 잡힌 이유는 명확하다. 각 태스크 리뷰는 “이 태스크 브리프와 구현이 일치하는가”만 본다.

    태스크 2에서 만든 값이 태스크 5에서 어떻게 쓰이는지는 태스크 2 리뷰어가 알 수 없다. 구조적으로 못 본다.

    이건 SDD 방식의 한계다. 태스크를 잘게 쪼갤수록 각 리뷰의 시야도 좁아진다.

    통합 테스트(integration test, 여러 부분을 합쳤을 때 전체가 제대로 동작하는지 확인하는 테스트)는 별도로 반드시 해야 한다. 태스크 리뷰가 다 통과했다는 말은 전체가 괜찮다는 말이 아니다.

    humanizer.ts 코드에서 최종 통합 리뷰 후 추가된 버그 수정 코드 두 군데가 초록색으로 강조 표시된 실제 diff 화면
    태스크 리뷰는 다 통과했지만, 최종 통합 리뷰에서 발견돼 나중에 추가한 안전장치.

    토큰 비용을 아끼기 위해 모델을 다르게 쓴 이유: haiku vs sonnet vs opus

    Claude 모델은 종류가 여러 개다. 그리고 비싸기도 다 다르다.

    모델 역할 이유
    haiku 각 태스크 구현 가장 저렴하다. 반복 작업에 쓴다.
    sonnet 태스크별 리뷰 중간 성능, 중간 가격. 리뷰는 구현보다 판단력이 필요하다.
    opus 최종 통합 리뷰 가장 비싸다. 전체를 한 번만 본다.

    논리는 단순하다. 비싼 모델을 모든 단계에 다 쓰면 비용이 선형으로 올라간다. 7개 태스크 구현에 opus를 쓸 필요가 없다.

    단순한 구현은 haiku로 충분하다. 판단이 필요한 리뷰는 sonnet을 쓴다. 가장 넓은 시야가 필요한 통합 리뷰에만 opus를 한 번 쓴다.

    역할에 맞는 모델을 쓰는 것. 이게 비용 관리의 핵심이다. 무조건 좋은 모델을 쓰는 게 답이 아니다.

    실제로 겪은 좌절과 배운 점: 자동화의 한계와 현실적인 조언

    솔직하게 쓴다.

    만들면서 헛된 꿈을 꿨다. 이걸로 수익을 벌 수 있을 거라는 생각. 지금 생각하면 웃긴다.

    애드센스 승인도 받지 않은 상태에서 수익을 먼저 계산했다. 순서가 완전히 틀렸다.

    중간에 4번 태스크 구현하다가 API 레이트리밋(rate limit, API를 너무 자주 호출하면 일시적으로 막히는 것, 에러 코드 429)에 걸려서 멈췄다.

    이건 잠깐 기다렸다가 재시도하니까 풀렸다. 그나마 간단한 문제였다.

    더 힘든 건 따로 있었다. 버그가 계속 나오는데, 고치면 또 나오고.

    토큰은 토큰대로 쓰고, 사용량은 사용량대로 올라가는데 결과물은 내 마음대로 안 됐다.

    다 그만두고 싶다는 생각을 몇 번이나 했다. 한두 번이 아니었다.

    버그보다 힘들었던 건 거절 메일이었다

    그때 심사 중이던 다른 애드센스 블로그에서 메일이 왔다. ‘가치가 별로 없는 콘텐츠’라는 이유로 불승인. 그거 보고 진짜로 힘이 빠졌다. ‘내가 지금 뭘 하고 있는 건가’ 싶었다.

    그래서 배운 건 이렇다.

    • 자동화는 반복 작업을 줄여준다. 판단을 대신해주지는 않는다.
    • 태스크 리뷰가 통과됐다고 끝이 아니다. 통합 테스트는 별도로 해야 한다.
    • 수익을 먼저 생각하지 마라. 콘텐츠 승인부터 받아라. 순서가 있다.
    • 버그가 계속 나오는 건 과정이다. 이상한 게 아니다. 그냥 고쳐야 한다.

    블로그 자동화 파이프라인은 일단 완성됐다. 다음 할 일은 정해져 있다. 일단 애드센스 신청 조건부터 다시 읽어볼 생각이다. 자동화 도구보다 그게 먼저다.

    참고로 크로스포스팅 자동화도 고려했었다. 근데 여러 이유로 결국 보류했다. 그 판단 과정은 이 글에 따로 정리해놨다.

    이 블로그를 왜 시작했는지는 소개 페이지에 더 적어놨다.

    예약 발행 기능을 따로 만든 과정은 예약 발행 기능을 직접 만들고 4개 글을 한 번에 올린 후기에 적어뒀다.