블로그 운영

  • 이미지가 삐져나가는 버그, 원인 찾고 자동화까지 한 후기

    이미지가 삐져나가는 버그, 원인 찾고 자동화까지 한 후기

    이미지가 삐져나가는 버그, 처음엔 그냥 넘어갈 뻔했다. 블로그 글을 올리고 나서 멀쩡히 보이는지 확인하는 건 습관이다. 그날도 그냥 훑어보고 있었다.

    이미지가 삐져나가는 버그, 눈에 띄는 이상함: 스크린샷 하나가 삐져나가 보였던 이유

    본문을 읽다가 뭔가 이상했다. 스크린샷 하나가 오른쪽으로 쏠려 있었다. 다른 이미지들은 멀쩡한데 그것만.

    이유는 몰랐다. 그냥 딱 봐도 어색했다. 바로 Claude Code(클로드 코드, AI 기반 코딩 보조 도구)에 말했다. “지금 본문에서 이 이미지만 오른쪽으로 쏠려있어. 사이즈 조절해서 중앙으로 보기 좋게 다시 작성해줘.” 원인 분석보다 고치는 게 먼저였다.

    아래가 당시 상태다. 텍스트 컬럼(column, 본문이 들어가는 세로 영역) 오른쪽으로 이미지가 넘쳐 있다.
    이미지가 삐져나가는 버그 — 텍스트 컬럼 밖으로 삐져나온 스크린샷

    이렇게 이미지가 본문 영역 밖으로 삐져나오면 레이아웃(layout, 화면 배치 구조) 전체가 깨진 것처럼 보인다. 작은 것 같지만 실제로 읽는 사람 입장에서는 바로 티가 난다.

    원인은 간단했다: 업로드 스크립트가 이미지를 줄이지 않고 있었네

    원인은 허무했다. 업로드 스크립트(script, 특정 작업을 자동으로 처리하는 코드 파일)가 이미지를 그대로 박아넣고 있었다. 리사이즈(resize, 이미지 크기를 줄이거나 늘리는 작업) 없이. 원본 그대로.

    원본 이미지의 가로 크기가 본문 컬럼 폭보다 훨씬 넓었다. 그러니 오른쪽으로 넘칠 수밖에 없다. 알고 나니 별거 아니었다. 근데 이게 지금까지 계속 이렇게 올라가고 있었다는 게 더 문제였다.

    이 버그(bug, 코드나 프로그램에서 발생하는 오류) 자체는 금방 고칠 수 있다. 문제는 따로 있다.

    버그 수정만으로는 부족한 이유: 같은 실수가 반복되면?

    지금 이 이미지만 고치고 끝내면 어떻게 될까. 다음에 글 올릴 때 또 같은 일이 생긴다. 스크립트가 그대로니까.

    버그를 발견했을 때 그 버그만 패치(patch, 문제가 생긴 부분만 부분적으로 고치는 것)하고 넘어가는 건 임시방편이다. 원인이 코드 안에 남아 있으면 같은 실수는 반드시 다시 나온다. 타이밍만 다를 뿐이다.

    그래서 바로 한 마디 더 붙였다. “처음부터 작성할 때 이런 것 체크해서 최종 마무리해줘.” 재발 방지까지 해야 진짜 끝난 거라고 생각했다.

    자동화로 근본 해결하기: 스크립트에 리사이즈 기능 추가하기

    수정 방향은 하나였다. 업로드 스크립트 자체를 고치는 것.

    이미지를 올릴 때마다 수동으로 크기를 확인하는 건 지속 가능하지 않다. 귀찮으면 빠뜨리게 돼 있다. 그러니 스크립트가 알아서 처리하게 만드는 게 맞다.

    Claude Code에 요청해서 업로드 스크립트를 수정했다. 핵심은 두 가지다.

    • 새 글을 올릴 때 이미지가 자동으로 본문 폭에 맞게 리사이즈된다.
    • 리사이즈된 이미지는 중앙 정렬(center align, 요소를 화면 가운데에 배치하는 것)로 삽입된다.

    이제 이미지 크기를 신경 쓰지 않아도 된다. 스크립트가 처리한다. 이게 자동화(automation, 사람이 직접 하던 작업을 코드가 대신 처리하도록 만드는 것)의 의미다. 한 번 제대로 만들어두면 그 다음부터는 신경 끄면 된다.

    재발 방지까지: 업로드 후 최종 확인 프로세스 정하기

    스크립트를 고치는 것만으로는 완전하지 않다고 봤다. 코드가 제대로 동작하는지 눈으로 확인하는 단계가 없으면 또 다른 문제가 조용히 지나갈 수 있다.

    그래서 규칙을 명확히 정했다. Claude Code에 이렇게 못 박았다.

    • 이미지는 본문 폭 안에 딱 맞게, 중앙 정렬로 들어가야 한다.
    • 업로드 후에는 Claude Code가 직접 최종 확인을 하고, 그 결과를 나한테 컨펌(confirm, 맞는지 확인하고 승인받는 것)받아야 한다.
    • 스크린샷으로 실제 화면을 직접 확인하는 것을 기본으로 한다.

    코드만 고치고 “됐겠지” 하고 넘어가지 않는다. 반드시 눈으로 확인한다. 이게 기준이다.

    이 사례에서 배울 점: 코드만 고치지 말고 프로세스도 함께

    이번 건 작은 버그였다. 이미지 하나가 삐져나간 것. 근데 거기서 멈추지 않은 게 핵심이다.

    버그를 고치는 건 시작이다. 왜 생겼는지 파악하고, 같은 일이 반복되지 않도록 구조를 바꾸고, 확인 단계까지 만드는 것이 진짜 마무리다.

    AI 도구를 쓸 때 “고쳐줘”만 하고 끝내는 사람이 많다. 그러면 똑같은 질문을 다음 달에 또 하게 된다. “왜 또 이러지?” 하면서.

    물어봐야 할 건 두 가지다.

    • 지금 이걸 어떻게 고치냐.
    • 앞으로 이게 안 생기려면 뭘 바꿔야 하냐.

    두 번째 질문을 안 하면 첫 번째 질문을 계속 반복한다.

    다음에는 업로드 스크립트 전체를 한 번 훑어볼 생각이다. 이미지 말고 다른 곳에서도 비슷한 게 조용히 지나가고 있을 수 있다. 결국 이미지가 삐져나가는 버그 하나가 전체 업로드 파이프라인을 점검하게 만든 셈이다.

    비슷한 패턴은 다른 데서도 반복됐다. WPCode로 보안 헤더 추가하다 코드가 깨진 사례도 결국 같은 교훈이었다 — 자동화 도구를 만들 땐 “일단 되는 것”과 “제대로 확인된 것”은 다르다.
  • Claude Code 7개 에이전트로 블로그 자동화 파이프라인 만들기

    Claude Code 7개 에이전트로 블로그 자동화 파이프라인 만들기

    블로그 자동화 파이프라인, 이번에 직접 만들어봤다.

    블로그 글 하나를 쓰려면 생각보다 손이 많이 간다. 인터뷰 정리하고, 개요 짜고, 본문 쓰고, 표현 다듬고, 워드프레스에 올리고. 이 과정을 자동화하면 어떨까 싶었다.

    Claude Code로, 에이전트(agent, 특정 역할을 맡아 자동으로 작업하는 AI) 7개를 동원해서.

    결론부터 말하면, 생각대로 됐냐고? 반반이다.

    Subagent-Driven Development란 뭔가: 7개 에이전트가 한 프로젝트를 나눠 맡다

    이번 프로젝트에서 쓴 방식의 이름이 있다. Subagent-Driven Development, 줄여서 SDD다.

    개념은 단순하다. 하나의 큰 작업을 태스크(task, 작은 단위의 할 일) 여러 개로 쪼개고, 각 태스크를 완전히 새로운 서브에이전트(subagent, 특정 태스크만 담당하는 하위 AI)한테 맡긴다.

    서브에이전트는 자기한테 주어진 태스크만 구현한다. 전체 맥락을 모른다. 그냥 시킨 것만 한다.

    구현이 끝나면 리뷰어 서브에이전트가 따로 붙는다. 리뷰어는 두 가지를 본다.

    • 스펙(spec, 무엇을 만들어야 하는지 적은 명세서)과 구현이 일치하는가
    • 코드 품질은 괜찮은가

    이 두 가지를 별도로 검사한다. 한꺼번에 보지 않는다. 역할을 나눠야 각자 더 잘 본다는 논리다.

    왜 이렇게 하냐고? AI 에이전트 하나한테 처음부터 끝까지 다 맡기면 컨텍스트 윈도우(context window, AI가 한 번에 기억할 수 있는 텍스트 분량)가 터진다.

    코드가 길어질수록 앞에 있던 내용을 잊어버린다. 태스크를 잘게 쪼개면 각 에이전트는 자기 몫만 처리하면 된다. 컨텍스트 부담이 준다.

    블로그 자동화 파이프라인 — ujinify-blog-generator: 인터뷰에서 게시물까지

    만든 것의 이름은 ujinify-blog-generator다. 파이프라인(pipeline, 데이터가 순서대로 처리되는 흐름)이라고 부른다. 입력에서 출력까지 단계가 정해져 있으니까.

    흐름은 이렇다.

    • 실제 인터뷰 데이터(질문-답변 형식)를 입력으로 넣는다
    • 그걸 바탕으로 개요를 자동으로 짠다
    • 개요를 가지고 본문을 쓴다
    • AI 티가 나는 표현을 자연스럽게 고쳐쓴다
    • 완성된 글을 워드프레스에 자동으로 업로드한다

    이 각 단계가 태스크 하나씩이다. 총 7개의 태스크, 7개의 서브에이전트. 인터뷰를 넣으면 게시물이 나온다. 적어도 설계는 그랬다.

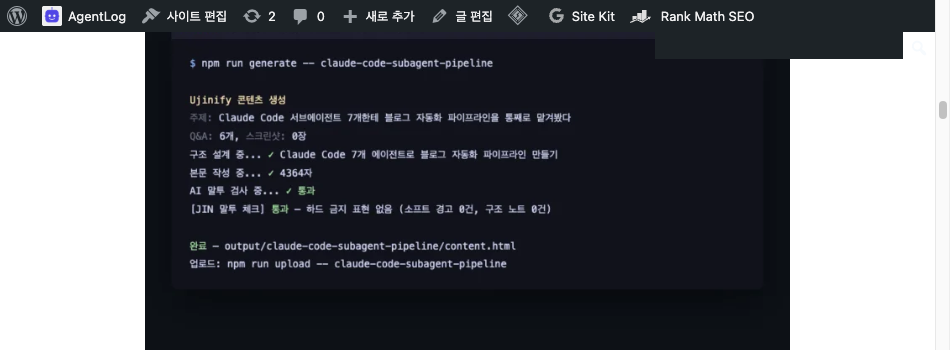
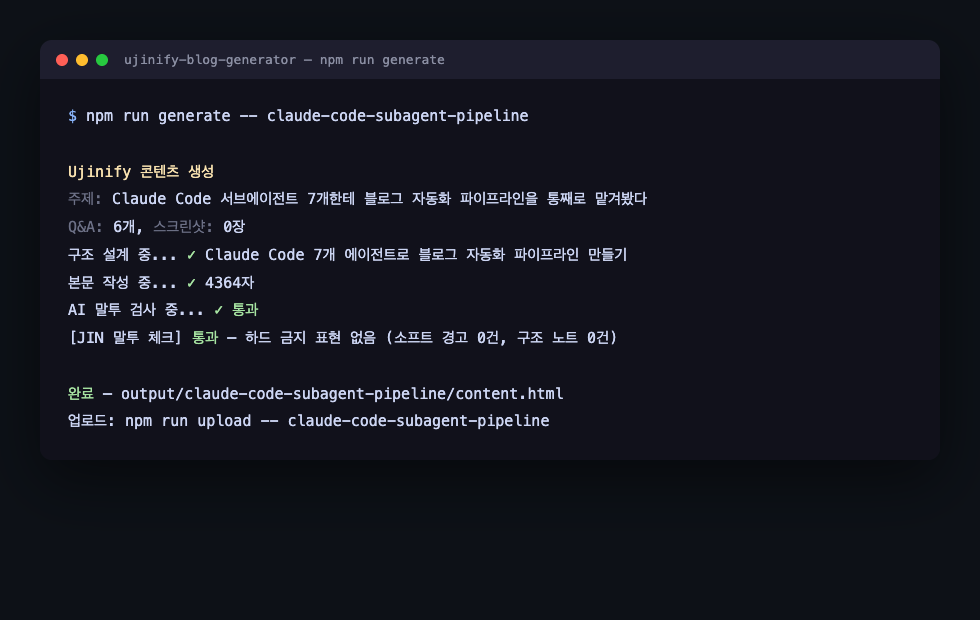
    블로그 자동화 파이프라인 실행 결과 — npm run generate 터미널 로그
    실제 generate 스크립트 실행 로그다. 인터뷰 데이터를 넣고 명령 하나 돌리면 본문까지 나온다.

    Git이 없는 프로젝트를 어떻게 관리했나: progress.md 방식의 진행 기록

    SDD 방식은 원래 깃(git, 코드 변경 이력을 저장하고 관리하는 도구)과 함께 쓰도록 설계됐다.

    워크트리(worktree, git에서 여러 브랜치를 동시에 다른 폴더로 펼쳐놓는 기능)로 브랜치를 분리하고, 커밋 diff(diff, 코드가 어떻게 달라졌는지 보여주는 변경 내역)를 리뷰 자료로 쓰는 식이다.

    그런데 이 프로젝트는 git 저장소가 아니었다. 그러니까 그 방식을 그대로 못 썼다.

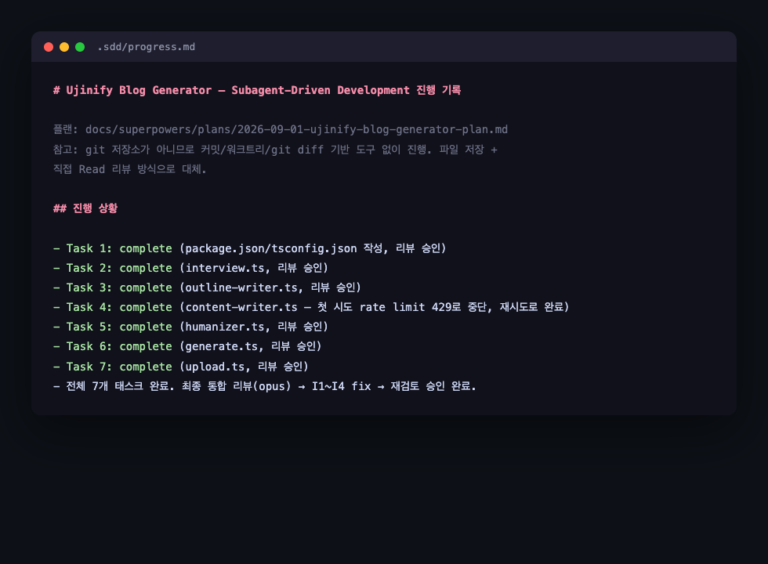
    해결책은 단순하게 잡았다. .sdd/progress.md라는 파일 하나를 만들고, 거기에 진행 상황을 계속 기록했다.

    태스크가 끝날 때마다 업데이트했다. 리뷰어 에이전트한테는 diff를 주는 대신, 실제 파일을 직접 읽게 했다.

    우아한 방식은 아니다. 그냥 작동했다. 그게 목적이었으니까 됐다.

    .sdd/progress.md 파일에 기록된 7개 태스크 진행 상황, 각 태스크의 완료 상태와 리뷰 승인 여부가 표시된 실제 파일 화면
    git 없이 진행 상황을 추적하려고 직접 만든 progress.md 기록.

    각 태스크는 통과했는데 왜 버그가 4개나 났을까: 통합 테스트의 중요성

    7개 태스크, 7번의 리뷰. 전부 통과했다.

    그래서 다 됐다고 생각했다. 아니었다.

    마지막에 오퍼스(opus, Anthropic이 만든 AI 모델 중 가장 성능이 높은 버전)로 전체를 한 번 더 통합 리뷰(integration review, 부분이 아닌 전체를 한꺼번에 검토하는 것)했다.

    그랬더니 버그가 4개 나왔다. 각 태스크 리뷰를 전부 통과한 코드에서.

    어떤 버그였냐면:

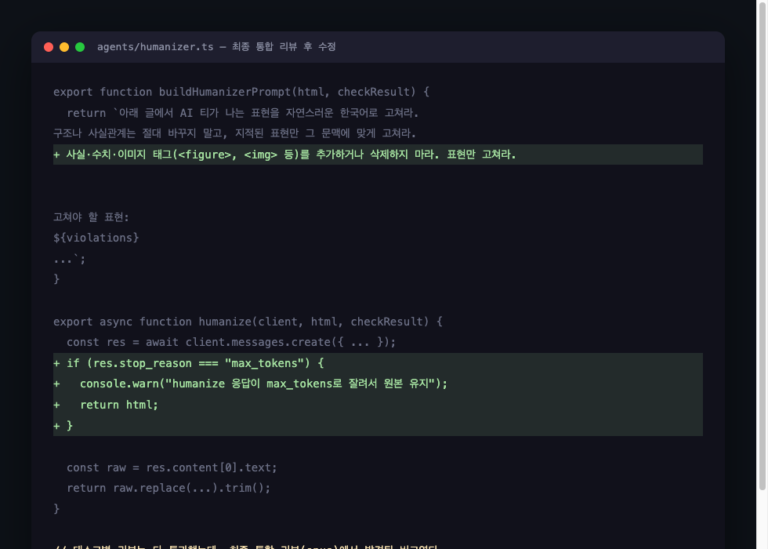
    • AI가 문장을 자연스럽게 고쳐쓰는 단계에서 스크린샷 태그가 조용히 사라질 수 있는 문제
    • AI 응답을 파싱(parsing, AI가 돌려준 텍스트에서 필요한 값을 꺼내는 것)할 때 값이 비어 있어도 그냥 넘어가고, 나중에 업로드 단계에서 크래시(crash, 프로그램이 갑자기 멈추는 것)가 나는 문제
    • 응답이 중간에 잘려도(max_tokens, AI가 한 번에 출력할 수 있는 최대 글자 수 제한) 아무 체크 없이 그대로 사용할 뻔한 문제

    왜 이런 게 태스크 리뷰에서 안 잡혔냐. 이유가 명확하다. 각 태스크 리뷰는 “이 태스크 브리프(brief, 태스크에서 무엇을 해야 하는지 적은 짧은 설명서)와 구현이 일치하는가”만 본다.

    태스크 2에서 만든 값이 태스크 5에서 어떻게 쓰이는지는 태스크 2 리뷰어가 알 수 없다. 구조적으로 못 본다.

    이건 SDD 방식의 한계다. 태스크를 잘게 쪼갤수록 각 리뷰의 시야도 좁아진다.

    통합 테스트(integration test, 여러 부분을 합쳤을 때 전체가 제대로 동작하는지 확인하는 테스트)는 별도로 반드시 해야 한다. 태스크 리뷰가 다 통과했다는 말은 전체가 괜찮다는 말이 아니다.

    humanizer.ts 코드에서 최종 통합 리뷰 후 추가된 버그 수정 코드 두 군데가 초록색으로 강조 표시된 실제 diff 화면
    태스크 리뷰는 다 통과했지만, 최종 통합 리뷰에서 발견돼 나중에 추가한 안전장치.

    토큰 비용을 아끼기 위해 모델을 다르게 쓴 이유: haiku vs sonnet vs opus

    Claude 모델은 종류가 여러 개다. 그리고 비싸기도 다 다르다.

    모델 역할 이유
    haiku 각 태스크 구현 가장 저렴하다. 반복 작업에 쓴다.
    sonnet 태스크별 리뷰 중간 성능, 중간 가격. 리뷰는 구현보다 판단력이 필요하다.
    opus 최종 통합 리뷰 가장 비싸다. 전체를 한 번만 본다.

    논리는 단순하다. 비싼 모델을 모든 단계에 다 쓰면 비용이 선형으로 올라간다. 7개 태스크 구현에 opus를 쓸 필요가 없다.

    단순한 구현은 haiku로 충분하다. 판단이 필요한 리뷰는 sonnet을 쓴다. 가장 넓은 시야가 필요한 통합 리뷰에만 opus를 한 번 쓴다.

    역할에 맞는 모델을 쓰는 것. 이게 비용 관리의 핵심이다. 무조건 좋은 모델을 쓰는 게 답이 아니다.

    실제로 겪은 좌절과 배운 점: 자동화의 한계와 현실적인 조언

    솔직하게 쓴다.

    만들면서 헛된 꿈을 꿨다. 이걸로 수익을 벌 수 있을 거라는 생각. 지금 생각하면 웃긴다.

    애드센스(AdSense, 구글이 운영하는 블로그 광고 수익 프로그램) 승인도 받지 않은 상태에서 수익을 먼저 계산했다. 순서가 완전히 틀렸다.

    중간에 4번 태스크 구현하다가 API 레이트리밋(rate limit, API를 너무 자주 호출하면 일시적으로 막히는 것, 에러 코드 429)에 걸려서 멈췄다.

    이건 잠깐 기다렸다가 재시도하니까 풀렸다. 그나마 간단한 문제였다.

    더 힘든 건 따로 있었다. 버그가 계속 나오는데, 고치면 또 나오고.

    토큰은 토큰대로 쓰고, 사용량은 사용량대로 올라가는데 결과물은 내 마음대로 안 됐다.

    다 그만두고 싶다는 생각을 몇 번이나 했다. 한두 번이 아니었다.

    그때 심사 중이던 다른 애드센스 블로그에서 메일이 왔다. ‘가치가 별로 없는 콘텐츠’라는 이유로 불승인. 그거 보고 진짜로 힘이 빠졌다. ‘내가 지금 뭘 하고 있는 건가’ 싶었다.

    그래서 배운 게 뭐냐고 물으면, 이렇게 말한다.

    • 자동화는 반복 작업을 줄여준다. 판단을 대신해주지는 않는다.
    • 태스크 리뷰가 통과됐다고 끝이 아니다. 통합 테스트는 별도로 해야 한다.
    • 수익을 먼저 생각하지 마라. 콘텐츠 승인부터 받아라. 순서가 있다.
    • 버그가 계속 나오는 건 과정이다. 이상한 게 아니다. 그냥 고쳐야 한다.

    블로그 자동화 파이프라인은 일단 완성됐다. 그래서 다음에 뭘 하냐고. 일단 애드센스 신청 조건부터 다시 읽어볼 생각이다. 자동화 도구보다 그게 먼저다.

    참고로 크로스포스팅 자동화도 고려했었다. 근데 여러 이유로 결국 보류했다 — 그 판단 과정은 이 글에 따로 정리해놨다.

    이 블로그를 왜 시작했는지는 소개 페이지에 더 적어놨다.